2026年8月30日日曜日

LLMは「答え」を生成しなくてもゲームを操作できるのか - 隠れ層からコントローラ操作を直接取り出す実験


☆ このブログ記事はチャッピー自動生成です ☆

LLMにゲームを操作させるなら、普通は操作を文字列として生成させる。例えばSnakeなら、ゲームの状態をプロンプトとして与えて、

{"action":"LEFT"}

のような回答を生成させる。それをプログラム側でパースし、実際のゲーム操作へ変換する。処理としては、

ゲーム状態
   ↓
LLMへ入力
   ↓
prefill
   ↓
decode
   ↓
"LEFT" を生成
   ↓
parse
   ↓
コントローラ操作

となる。

LLMエージェントとしては、ごく普通の構成だ。ただ、ゲームのコントローラを動かしたいだけだと考えると、少し回りくどい。LLM内部ではすでにゲーム状態を処理し、

次は左へ行く

という判断につながる何らかの内部状態を作っているはずだ。それをいったん、

"LEFT"

という言語へ変換し、外側のプログラムでもう一度、

LEFTボタン

へ戻している。つまり、

内部表現
 ↓
言語
 ↓
操作

という経路を通っている。では、この真ん中の「言語」は本当に必要なのだろうか。今回試したかったのはそこだった。


decodeを通さずに操作を取り出したい

目標は単純で、

LLMに操作名を生成させず、prefill後の内部状態から直接コントローラ操作を取り出す

ことである。つまり、

ゲーム状態
   ↓
LLM prefill
   ↓
hidden state
   ↓
LEFT / RIGHT / UP / DOWN

としたい。これができれば、LLMは一文字も生成しなくてよい。

ゲームの状態を見せる。

Transformerを通す。

途中の内部状態を読む。

そのままボタンを押す。

LLMを「テキストを生成する装置」としてではなく、

入力から行動に必要な内部表現を作る巨大な計算器

として使うことになる。


decodeを省きたい理由は、速度だけではない

もちろんdecodeを省略できれば、その分の計算コストは減る。しかし今回興味があるのは、単純な高速化だけではない。ゲームには時間の流れがある。例えばSnakeなら、

t=0
Snake: (3, 4)
Food:  (8, 4)

t=1
Snake: (4, 4)
Food:  (8, 4)

t=2
Snake: (5, 4)
Food:  (8, 4)

t=3
...

というように状態が連続して変化する。これを毎tick独立した問い合わせとしてLLMへ投げるのではなく、ゲームの進行そのものをコンテキストへ追加し続けることもできる。

State(t=0)
    ↓
prefill

State(t=1) を追加
    ↓
incremental prefill

State(t=2) を追加
    ↓
incremental prefill

State(t=3) を追加
    ↓
...

KV Cacheを維持したまま、ゲームの時系列をLLMへ読み込ませ続ける。ここで一つ仮説がある。

ゲームの状況が時間とともに変化すれば、それに対応してLLMの隠れ層も変化していき、その変化の中に「今どの操作をすべきか」という情報が現れるのではないか。

イメージとしては、

game state:
S0 → S1 → S2 → S3 → S4

hidden state:
h0 → h1 → h2 → h3 → h4

という対応である。

そして、

h2 では RIGHT
h4 では LEFT

のように、その時点の内部状態から操作を読めるかもしれない。さらに言えば、絶対的なhidden stateだけではなく、

h(t) - h(t-1)

のような変化量に操作情報が出る可能性もある。この「時系列に沿って変化する内部状態」を使いたいというのが、decodeをできるだけ避けたいもう一つの理由だった。


decodeしてrollbackする方法もある

もちろん、ゲームの時系列をprefillし続けながら操作を取り出す方法は他にもある。例えば、ある時点で推論状態をcheckpointして、

State t
  ↓
prefill
  ↓
checkpoint
  ↓
数token decode
  ↓
{"action":"LEFT"}
  ↓
actionを取得
  ↓
rollback

とすることもできる。自前の推論エンジンを持っていれば、このような処理は比較的自由にできる。ゲームの履歴やKV Cacheは維持しつつ、操作が必要な瞬間だけ一時的にdecodeする。そして操作を取得したら、decode前の状態へ戻る。これはかなり現実的な方法だと思う。LM Headも既存のものをそのまま使える。モデルを追加学習する必要もない。

ただし、毎tickこれを行うとなると、それなりにコストが高い。


actionが欲しいだけなのに文字列を作る?

ゲームが1秒に何回も進行する場合、

checkpoint
↓
decode
↓
parse
↓
rollback

を何度も繰り返すことになる。しかも必要なのはせいぜい、

LEFT

という数bit相当の情報である。それを取得するために、

{
  "action":
  "LEFT"
}

という文字列を何tokenも生成するのは、どう考えても贅沢だ。もちろんプロンプトを工夫して、

L

の1 tokenだけ出させることもできる。しかしそれでも、

  • Transformerのdecode step

  • LM Head

  • 全語彙へのlogits計算

  • sampling

  • KVの更新

  • rollback

などは残る。欲しいものが5種類程度のactionなら、もっと直接取り出せないだろうか。


decodeをどこまで削れるか

実際、actionを取得する方法には何段階かある。

1. JSONを最後まで生成する

2. "LEFT" のような操作名だけ生成する

3. L/R/U/Dなど1 tokenだけ生成する

4. LM Headのlogitsを直接読む

5. hidden stateからactionを直接分類する

6. hidden stateの時間変化からactionを読む

下へ行くほどLanguage Modelとしてのdecodeから離れていく。

今回試しているのは5番目である。

LM Headすら通さず、Transformer途中のhidden stateから操作を取り出せるか。


LLMの「脳」に電極を刺してみる

今回はGemma 4 E2Bを llama.cpp で動かした。そして通常なら外から見ることのない計算グラフ途中のtensorを観測した。取得したのは、

llama_cpp_graph_tensor:l_out-17

というtensorで、1536次元のvectorが得られる。概念的には、

ゲーム状態
   ↓
Transformer
   ↓
Layer ...
   ↓
hidden state ─────→ ここを読む
   ↓
Layer ...
   ↓
LM Head
   ↓
token

という形になる。

モデル本体は変更していない。

weightを書き換えていない。

LoRAも入れていない。

新しいheadも追加していない。

既存モデルを普通に動かし、その途中を横から観測しているだけである。

自分の中では、これはLLMの「脳」に電極を刺すようなイメージに近い。新しい回路を埋め込むのではなく、すでに流れている信号を外から読む。


1536次元からコントローラのボタンを読む

当然ながら、1536個のfloatを眺めても何をしたいのかは分からない。そこで外側に小さなdecoderを置く。今回は多項ロジスティック回帰を使った。つまり、

1536次元 hidden state
          ↓
      linear probe
          ↓
LEFT / RIGHT / UP / DOWN / NONE

という非常に単純な分類器である。意図的にlinear probeを使っている。複雑なニューラルネットを外側に置いてしまうと、

そのdecoder自身がゲームを理解しているのでは?

という問題が出てくる。今回は、

LLM内部に、すでに操作を読み出せる情報が存在しているか

を見たい。なのでdecoderはなるべく弱くした。


教師データはLLM自身から作る

では、hidden stateに何を正解として学習させるのか。今回は人間がSnakeの最適手を教えたわけではない。学習データを作る段階だけは、通常通りLLMをdecodeする。例えばLLMが、

{"action":"RIGHT"}

と出したとする。

そのとき、decode前に取得しておいたhidden stateに、

RIGHT

というラベルを付ける。構造としては、

                 ┌── hidden state ──→ 学習データ
ゲーム状態 → LLM
                 └── decode → RIGHT ─→ 教師ラベル

となる。つまり学習しているのは、

このゲーム状態ではRIGHTが正しい

というpolicyではない。そうではなく、

このLLMがこの内部状態から最終的にどの操作をdecodeしようとしているか

を予測している。最初は通常decodeを教師として使い、その後でdecodeを取り外せないか試すわけだ。


「次tokenを読んでいるだけ」ではないのか

hidden stateからRIGHTが当たったとしても、

単に次に "RIGHT" tokenが出ることを予測しているだけでは?

という疑問は当然ある。それならactionを読んでいるというより、next-token predictionを横から盗み見ているだけになる。そこで、同じ操作について複数の表記を用意した。

例えば右移動なら、

D
Right
右

左移動なら、

A
Left
左

とする。

ゲーム内部ではすべて共通actionへ正規化する。

D
Right
右
   ↓
RIGHT

こうすることで、特定の文字列だけをlinear probeが拾う可能性を多少減らせる。ただし、これだけでは十分ではない。よりちゃんと検証するなら、

WASD + Englishで学習
          ↓
日本語表記だけで評価

のようなVocabulary Holdoutも必要になる。もしこれでもactionを読めれば、単なるtoken予測より一段抽象化された情報を拾っている可能性が高くなる。


本気で作るなら専用Action Headの方が正しいと思う

ここまで「モデルを改造しない」ことにこだわってきたが、本当に性能を求めるなら、おそらく今回の方法が最終形ではない。

自然なのは、どこかのhidden layerから専用のaction headを分岐させることだと思う。

Transformer
     │
     ├── LM Head → language
     │
     └── Action Head → controller

例えば、

hidden state
    ↓
small MLP
    ↓
action logits

とする。

本体をfreezeしてheadだけ学習してもよい。LoRAなどで内部表現そのものをaction向けに調整する方法もある。実用的なVLAやpolicy modelを作るなら、たぶんこちらが本筋になる。ただ、それをやってしまうと、

actionを出すようにモデルを改造したからactionが出た

という話になる。今回まず知りたかったのは違う。既存LLMを一切変更しなくても、内部にはすでにactionとして利用できる情報が流れているのか。だから今回は外からhidden stateを観測するだけにした。

まず電極で読んでみて、それで面白そうなら次に専用の回路を付ければよい。


まずSnakeで試す

最初に使ったのはSnakeだった。ゲームの盤面、Snakeの位置、Foodの位置、現在の進行方向などをテキストでLLMへ与える。通常通りdecodeして操作を取得すると同時に、l_out-17 のhidden stateも保存する。そこからlinear probeを学習した。未使用seedで評価すると、一致率は、

81.25%

だった。ただし、この値だけを見ると誤解しやすい。Snakeでは直進、つまり NONE がかなり多かった。多数派クラスを選び続けても高い精度になってしまうため、81.25%そのものを強い結果とは言えない。

この段階で確認できたのは、

decode前のhidden stateに、最終的な操作と相関する信号が含まれている

というところまでだ。次はactionの分布を均等にしたdatasetで評価する必要がある。


ブロック崩しでも同じ場所を読んでみる

Snakeだけでは、そのゲーム特有の特徴を拾っている可能性がある。

そこでブロック崩し(Breakout)でも試した。

操作は、

LEFT
RIGHT
NONE

の3種類。使うモデルは同じGemma 4 E2B。観測位置も同じ l_out-17

そこから同じ1536次元vectorを取得する。

Breakout専用のlinear probeを学習して未使用episodeで評価すると、

70.0%

だった。

多数派baselineは66.7%。

大きな差ではないが、少なくともSnake以外のゲームでも同じ場所から操作に関連する信号は取れた。


SnakeとBreakoutで同じdecoderを使えるか

次に試したのは、ゲームをまたいでactionが共有できるかである。

SnakeにもLEFTがある。

BreakoutにもLEFTがある。

そこで両者の操作を、

LEFT
RIGHT
UP
DOWN
NONE

という共通actionへ正規化した。probeにはgame IDを教えない。入力は純粋な1536次元hidden stateだけ。

そこから1つのlinear probeでactionを分類する。結果は、

評価対象Accuracy
Snake + Breakout77.27%
Snake80.0%
Breakout70.0%

だった。少なくともSnakeとBreakoutについては、

同一モデルの同一観測地点から、一つのlinear decoderである程度共通の操作を取り出せた。


では未知のゲームにも使えるのか

ここまで来ると、

LLM内部にはLEFTやRIGHTのような汎用的なaction表現があるのではないか

と期待したくなる。そこでTetrisを追加した。

Snake + Breakoutだけで学習したprobeを、そのままTetrisへ適用する。再学習はしない。

ゲーム単位ではzero-shotになる。結果は、

7.69%

だった。多数派baselineよりも悪い。


「LEFTニューロン」を見つけたわけではない

この結果を見る限り、

この方向 = LEFT
この方向 = RIGHT

という普遍的な単純軸がhidden spaceに存在しているのを見つけた、とはいえなそうだ。

hidden stateには、

  • ゲーム状態

  • プロンプト構造

  • 出力形式

  • 選択可能なaction

  • 次token情報

  • ゲーム固有の判断

などが混ざっている。SnakeとBreakoutでは、その中から共通して利用できる方向をlinear probeが拾えた。しかしTetrisでは対応関係が崩れた


さらに先にはVLMがある

今はゲーム状態をテキストとして与えている。しかし、この考え方はVLMでもできるはずだ。最終的にはゲーム画面そのものを入力して、

screen / video frame
        ↓
       VLM
        ↓
hidden representation
        ↓
      action

としたい。普通にVLMを使えば、

画面
 ↓
VLM
 ↓
"The ball is moving left, so move the paddle left."
 ↓
parse
 ↓
LEFT

のような構成になる。しかし必要なのがcontroller actionだけなら、この文章は本来不要である。VLMが内部で、

  • 自機の位置

  • ボールの位置

  • 敵の位置

  • 移動方向

  • 危険

  • 次の行動

などを表現できているなら、その途中からactionだけ抜けばよい。究極的には、

video
  ↓
VLM
  ↓
latent dynamics
  ↓
controller

で動かせるかもしれない。ゲームであれば、これはかなりVLAに近い構造になる。


今回の実験で分かったこと

今回やったのは、まだかなり小さな実験である。

Gemma 4 E2Bをそのまま動かし、llama.cpp の途中から1536次元hidden stateを取得した。

モデル自体は変更せず、外側に単純なlinear probeを付けた。

SnakeやBreakoutでは、LLM自身のdecode結果と相関するactionをある程度読み取れた。

SnakeとBreakoutを混ぜた共通decoderもある程度機能した。

一方で、そのdecoderを未知のTetrisへzero-shotで持っていくと完全に失敗した。

なので現時点では、

LLM内部に普遍的なLEFT/RIGHT表現を発見した

とは到底言えない。

それでも、

LLMが言語として答えを出す前のhidden stateに、外部操作へ利用できる情報が存在している

という感触は得られた。

2026年8月23日日曜日

novelmat - LLMに文章を書かせず、「次に何を書きたいか」だけ覗いてテキストフィルタを作った

☆ この blog は チャッピー生成です☆


OCR文章の不要な改行を消すために、LLMへ文章を書き直させるのをやめた。
代わりにやったのは、数十トークン読ませて、logitsを数個盗むことだった——


OCRすると「そこは改行じゃないだろ」という場所で切れる

書籍をOCRすると、こんなテキストができることがある。

吾輩は猫であ
る。
名前はまだない。

元の紙面では単に行が折り返されていただけなのに、OCR結果には改行文字が入っている。

欲しいのは当然、

吾輩は猫である。
名前はまだない。

である。

一見すると簡単な問題に見える。

ところが、「日本語のどこが文章の区切りなのか」を機械的に判断しようとすると、意外と面倒だ。

形態素解析器を使う方法も考えられる。品詞を見たり、文末表現を判定したり、句読点や括弧を考慮したりすることもできるだろう。

しかし小説には、

  • 会話文

  • 句読点の省略

  • 三点リーダ

  • 括弧

  • 倒置

  • 文の途中でのページ送り

  • OCRによる文字欠落

などが普通に出てくる。

「句点なら文末」「助詞ならまだ続く」といった規則だけでは、すぐに例外が増えていく。

もちろん、きちんと日本語解析の仕組みを作れば解決できる問題ではある。

ただし、改行を1個消すために、日本語の文境界判定器を一から育てたいわけではない。

そこで考えた。

LLMはすでに大量の日本語を学習している。

だったら、その能力をもっと雑に奪えないだろうか。


最初は、「普通に」ChatGPTやQwenに直してもらっていた

実は、最初からこんな仕組みを作ろうと思っていたわけではない。

当初の運用はもっと単純だった。

OCRしたテキストファイルをQwenやChatGPTなどのLLMへ渡して、

OCRによって入った不要な改行を取り除いてください。文章そのものは変更しないでください。

と頼んでいた。

これで済むなら、それが一番楽である。

実際、短い文章ではかなりうまくいく。

しかし、ある程度まとまったテキストを処理させると、だんだん困ったことが起きた。

たとえば、

  • 頼んでいない誤字修正をする

  • 句読点や表記を勝手に整える

  • 文体を微妙に変える

  • 消してほしい改行をいくつか残す

  • 長い文章になると途中の作業が抜ける

といったことがある。

プロンプトで、

改行以外は絶対に変更しない

と強く指定しても、完全には安定しなかった。

LLMからすれば、文章全体を一度生成し直す以上、これはある意味当然でもある。

こちらが欲しいのは、

この改行を残す

か、

この改行を消す

かだけなのに、LLMには文章全体を書き直す権限を渡している。

かなり大げさな仕事の頼み方だった。

特に困るのは、結果が一見まともに見えることだ。

数千文字の文章のうち一か所だけ書き換えられていても、人間が目視で発見するのは難しい。

逆に、不要な改行が一つ残っていても同じである。

生成系LLMへ全文編集を任せる方法は便利ではあるものの、

「入力の文字列をほぼ完全に保存しながら、指定した改行だけを機械的に除去する」

という用途では、思ったより扱いづらかった。

そこで発想を逆にした。

そもそもLLMに文章を書き直させなければいいのではないか。

文章を生成させるから、余計な変更も作業漏れも起きる。

でもLLMが、

この改行は不自然だ

と判断する能力そのものは使いたい。

だったら完成した文章を返してもらうのではなく、

LLMがその場所で次に何を書こうとしているかだけを覗けばいい。

今回の novelmat は、そこから始まった。


文章を生成させるために使う「LLM」

LLMというと、普通は文章を生成させるために使う。

質問を投げれば答えを書いてくれる。要約を頼めば要約してくれる。OCRの誤りを直したいなら、

この文章を自然な日本語に修正してください

と渡せば、それらしい文章を返してくれる。

もちろん、それでもいい。

でも今回やりたかったのは、少し違う。

LLMには文章を書かせない。

代わりに、

「この続きを書くなら、次に何を書こうとしている?」

という情報だけを取り出すことにした。


LLMは「次に何が来るか」を知っている

LLMが

吾輩は猫であ

まで読んだとする。

次のトークンを生成するとき、内部ではざっくり、

「る」       ← かなりありそう
「り」
「る。」
「\n」       ← これはかなり変
「猫」
...

のように、語彙に存在する大量のトークンすべてへスコアを付けている。

普段のLLM利用では、その確率分布から1トークンを選び、

と実際に生成させる。

今回は生成させない。

その一歩手前で止めて、確率分布だけ読む。

これだけで、

吾輩は猫であ
↓
「\n」はどのくらい出したい?
「る」はどのくらい出したい?

を数値として比較できる。

つまり、LLMを文章生成器ではなく、日本語の違和感センサーとして使う。


形態素解析器を作り込む代わりに、LLMの出力を横取りする

何故こんな事を考えるのか?

日本語の文境界をちゃんと認識する仕組みを作ろうとすれば、それなりの実装になる。

形態素解析して、

助詞だから続きそう
終助詞だから切れそう
句点だから切れそう
でも括弧の中なので……

と考えることになる。

さらにOCR特有の壊れ方まで扱おうとすると、ルールは増えていく。

一方LLMは、そもそも、

吾輩は猫であ

を見せた時点で、

次はたぶん「る」だろう

という判断をしている。

ならば、その判断をそのまま盗めばいい。

日本語の構造をこちらで明示的に解析する必要はない。

必要だったのは、

  1. 問題の位置までLLMに読ませる

  2. logitsを取る

  3. 改行と次トークンのスコアを見る

だけだった。

専用モデルを学習したわけでもない。

形態素解析の辞書を調整したわけでもない。

大量の日本語ルールを書いたわけでもない。

それでも、それなりにうまくいく。

LLMの出力を奪うのは、手間のわりにかなり性能がいい。


改行あり vs 改行なしをLLMに競わせる

文章が

A\nB

となっているとする。

まず、改行しない場合を考える。

A → B

について、LLMがBをどの程度自然だと思っているかを見る。

一方で、改行を残す場合は、

A → \n → B

という系列を見る。

log probabilityを使えば、これらを比較できる。

たとえば、

吾輩は猫であ
る。

なら、「吾輩は猫であ」の次に「る」が来る確率は高い。

一方、その途中に突然改行を挟む確率は低い。

だったら、

この改行はOCRによって紛れ込んだ可能性が高そうだ

と判断できる。

逆に、

吾輩は猫である。
名前はまだない。

なら句点後の改行はそれほど不自然ではない。

重要なのは、こちらが、

「ある。」は文末です

というルールを教えていないことだ。

LLMがすでに持っている日本語予測能力を利用しているだけである。


「日本語を理解させて答えを書かせた」わけではない

ありがちな実装なら、

あなたは日本語校正者です。
以下のOCR結果から不要な改行を削除してください。

とLLMに頼み、

吾輩は猫である。
名前はまだない。

という完成テキストを生成させる。

しかし、それをするとLLMにはかなり大きな自由が与えられる。

誤字を直すかもしれない。

句読点を変えるかもしれない。

表記を整えるかもしれない。

原文そのものを書き換えるかもしれない。

今回ほしいのはそんな高度な校正ではない。

この1文字の \n を消すか、残すか。

それだけだ。

そこでLLMには編集権限を与えない。

聞くのは、

この位置で \n をどのくらい出したかった?
その代わり次の文字をどのくらい出したかった?

という内部情報だけ。

最終的にファイルを書き換えるのは普通のPythonコードである。

AIに仕事を丸投げするというより、

日本語能力だけ借りる。


「生成させない」は速度面でも重要だった

この方法には、精度や制御のしやすさ以外にもう一つ大きな利点があった。

ほとんどdecodeしなくていい。

普通にChatGPTやQwenへ、

この文章から不要な改行を取り除いて、修正後の全文を出してください

と頼む場合、LLMは入力をprefillしたあと、修正済みの文章を最初から最後までdecodeして生成する。

たとえば数千トークンの文章を処理するなら、入力側の数千トークンを読むだけでなく、出力側でもまた数千トークンを1トークンずつ生成することになる。

LLM推論では、このdecode部分がかなり重い。

生成は基本的に、

1 token生成
↓
KV cacheを使って次の1 token生成
↓
また次の1 token生成
↓
...

と逐次的に進む。

文章が長ければ、そのぶん何千回もforwardする必要がある。

一方、今回欲しいのは修正済みの文章そのものではない。

ある位置まで、

吾輩は猫であ

とLLMに読ませて、

次は「る」なのか?
それとも改行なのか?

というlogitsを一度見るだけでよい。

つまり処理の大部分をprefillとしてまとめて流せる

prefillは複数トークンをまとめて行列演算できるので、decodeのように1トークンずつ逐次生成するより圧倒的にGPUを使いやすい。

今回の処理は感覚的には、

普通のLLM校正

長い入力をprefill
        ↓
長い修正版をdecode
decode
decode
decode
decode
...

ではなく、

novelmat

周辺テキストをprefill
        ↓
logitsを数個読む
        ↓
終わり

に近い。

LLMを使っているのに、ほとんど文章を生成しない。

そのため、普通にLLMへ全文を校正させる方法と比べるとかなり速い。

これは今回の用途と相性がよかった。

欲しいのは文章そのものではなく、

この場所では何を書こうとしていたか

という一瞬の判断だけだからである。


「これから校正する」と思わせてから確率を取る

先にLLMへ、

あなたの役割は日本語ライトノベルの校正担当です。
OCRで生成された日本語文を修正してください。

#で始まる行はページ情報なので残してください。
ページをまたいだ文は前ページ側へ統合してください。

といった指示やfew-shot例を見せておく。

その後、

Assistant:
吾輩は猫であ

までをprefillする。

しかし、やはり生成はさせない。

「これから校正結果を書くつもりになったLLM」が次に何を書きたがっているかだけを見る。

この使い方では、プロンプトは回答を生成させるためだけのものではなく、

次トークンの確率分布そのものを目的に合わせて変える手段

になる。指示のほか、参考にする画像をprefillするなどしても面白そうだ。


llm-jp-4への単純なモデル差し替えはうまくいかなかった

日本語を扱うなら、日本語特化モデルのほうがうまくいくのではないか。

そこで llm-jp-4-8b-thinking も試した。

ところが、Gemmaで使っていた判定基準をそのまま持っていくと、期待した結果にはならなかった。

たとえば、

今日はいい天気ですね。
明日も晴れるといいな。

のような通常の文間でも、Gemma用に決めた基準では改行を削除する側へ寄りやすかった。

最初は、

日本語特化モデルなのに意外だな

と思った。

しかし、考えてみれば判定ロジックそのものをGemmaのlogit分布を観察しながら作っている。

モデルが変われば、

P(\n)
P(next token)

の絶対値も、差の出方も、分布の形も変わって当然である。

つまりこれは、

llm-jp-4がこの用途に向いていない、という結果ではない。

むしろ、

モデルごとに判定基準をチューニングする必要がありそう

という話だと思う。

Gemma向けに作った閾値をllm-jpへそのまま持っていって、

Gemmaのほうが優秀だった

と結論するのは早い。

今後モデルを差し替えるなら、少量の教師データから閾値を自動的に合わせたり、logit差を正規化したりする仕組みがあってもよさそうだ。


26万語を毎回ソートして41秒かかっていた

最初は llama.cpp / llama-cpp-python の通常のlogprobs取得APIを使っていた。

ところが、やたら遅い。

調べてみると、必要なのは、

P(\n)
P(next_token)

という数個の値だけなのに、API側では巨大な語彙全体をソートしていた。

今回使ったモデルの語彙は約26万トークン。

それを何度もsortする。

3改行を見るだけで、

約41秒

かかっていた。

さすがにテキストフィルタとは呼びづらい。

そこで通常のcompletion APIを迂回し、

model.eval(tokens)
logits = model._scores

からraw logitsを直接取得するようにした。

あとはnumpyでlog-softmaxして、

p_newline = logprobs[newline_token_id]
p_next = logprobs[next_token_id]

だけ取り出せばいい。

必要なのは2要素程度なのだから、26万要素を順位順に並べる必要はない。

その結果、

3改行: 約41秒 → 約1秒

まで縮んだ。

全文を毎回読ませるのも無駄なので、現在は判定位置の前後約50トークンだけを見る。

最終的には、

数十トークン読ませて、logitsを数個盗む

という非常に小さな処理になった。


最後はsedみたいになった

こうしてできたのが novelmat である。

基本は、

novelmat input.txt

標準入力も使える。

cat input.txt | novelmat

ファイルを直接書き換えることもできる。

novelmat -i input.txt
novelmat -i.bak input.txt

判定結果だけJSONで確認することもできる。

novelmat --detect input.txt -o result.json

LLMアプリなのに、UIもチャット画面もない sed のような使い心地。


LLMは「文章生成API」だけではない

LLMを普通に使っていると、

prompt → generated text

というインターフェイスだけを見がちである。

しかし実際には、その途中に、

context
    ↓
巨大なtoken probability distribution
    ↓
sampling
    ↓
next token

がある。

我々が普段受け取っている文章は、その巨大な情報から最後に1個だけ選ばれた結果だ。

その手前には、

次に改行したい度
次に「る」と書きたい度
句点を書きたい度
EOSを出したい度

が全部入っている。

だったら、生成させずにそこを使ってもいい。

今回の改行フィルタは、その小さな例でしかない。

同じ考え方なら、たとえば、

  • OCR結果がページ末で途中切れしているか

  • 2つのテキスト断片が連続しているか

  • ここに句読点があるべきか

  • 改行すべき位置はどこか

  • 語尾が欠落していないか

  • 文書の境界らしいか

といった問題も、次トークン確率から拾える可能性がある。

こうした問題をまじめに解こうとすれば、形態素解析、構文解析、ルール、専用classifierなど、いろいろな方法がある。

それらが不要という話ではない。

精度や説明可能性が重要なら、専用手法のほうが適している場合も多いだろう。

ただ、

ちょっと日本語らしさを判定したい

という用途では、すでに手元にあるLLMへ文章を食わせ、次に何を出したがっているかを横取りするだけでも、意外なほど使える。

専用の日本語処理系を組み立てるより実装の手間が少なく、しかもモデルがすでに持っている大量の言語知識をそのまま利用できる。

日本語は英語などのように区切りが明確ではなく、形態素解析などしても正確な情報が得られるわけではない前提において、これはかなり便利な性質だと思う。


まとめ -「AIに直してもらう」より「AIが何を書こうとしたかを見る」

今回の novelmat は小さなツールである。

やっていることも最終的には、

この改行を残す / 消す

という二値判定にすぎない。

ただ、実装していてLLMとの付き合い方が途中から変わった。

最初は、

LLMならこの日本語を直せるのでは?

だった。

それが、

LLMはこの位置をどう感じているんだろう?

になり、

最終的には、

答えは書かなくていいから、その瞬間のlogitsだけ見せて

になった。

日本語の文章境界を見つける仕組みをこちらで頑張って作る代わりに、

LLMがすでに持っている「続きを予測する能力」を横から奪う。

少々乱暴だが、手間の割にはよく働く。

LLMは文章生成器として非常に便利だ。

でも、生成される文章はLLMが持っている情報のごく一部でもある。

その手前にある確率分布を覗いてみると、

昔ながらの小さなUNIXフィルタの中に、LLMをひっそり埋め込む

みたいな使い方もできる。

novelmat は、そんな実験になった。

2026年6月2日火曜日

Bambo Labs P1S のノズルつまり解消 (フィラメント供給口が詰まったホットエンドの復旧)

 ABS 素材を使用した後にフィラメントが完全に詰まってしまい、放置していた3Dプリンタを復旧しました。


FDMプリンタのしくみ

すごい雑な図面しか作らないけども、まず何故これからの作業でノズル詰まりが解消するのかを考察してみます。正常状態では押し出しギアで押し出されたフィラメントがホットエンドに送りこまれ、加熱されたノズル内で溶けて排出されます。


強制的な押し出しとコールドプル

この状態フィラメントを強制的に押し出すには以下の作業をします。

  • ノズル温度を 250~270度ぐらい(詰まっているノズルでフィラメントが溶ける温度)にする
  • その状態で、フィラメントを押し出しギアから押し込む
  • ノズルから古いフィラメントが抜ける
また、これでノズルからフィラメント上に引き抜くのがコールドプルです。
  • ノズル温度を 250~270℃ぐらいにする
  • フィラメントに押し出してノズルを満たす
  • ノズル温度を常温に戻して、フィラメントを個体化させる
  • ノズル温度を80℃ぐらいに上げる
  • フィラメントを上に引き抜く
    • 押し出しギアを逆回転させる方法
      • 利点:これで済めば楽
      • 欠点:引き抜いたフィラメントが押しだしギアとホットエンドの間に残る可能性がある
    • ホットエンドをと外した状態で手でフィラメントを引き抜く方法
      • 利点:わかりやすい
      • 欠点:目的温度までホットエンドを温める方法が必要(プリンタ操作)、ホットエンドから手動で引き抜きにはホットエンドを外す必要がある(プリンタから外さないといけない)
しかし今回はこのパターンでは解消しないタイプの詰まりでした。。。


ホットエンド入り口が詰まった状態のノズル → 加熱した金属棒でフィラメントを加熱

ホットエンドを加熱しても、ホットエンド入り口にあるフィラメントの塊が過熱されず、フィラメントを押し出しできない状態でした。
今回はこの状態だったので、加熱した六角レンチでホットエンドのフィラメント供給口を押してあげることで解決しました。


  • 六角レンチを温める。
    • 手許ではガスコンロの火を使った
    • 六角レンチが赤くはならないが、熱でめっきが変色するぐらいまで加熱した
    • 手でレンチを持っていても問題ない程度だった
  • ホットエンドのフィラメント供給口に六角レンチを押し当てる。
    • これによりフィラメントが溶ける。フィラメントを通じてノズルが熱くなるので注意
  • フィラメント供給口をふさいでいたフィラメントの塊をノズルに押し込めた
    • レンチなどにフィラメントを絡めて上に引き抜く「コールドプル」はできていない
この状態で、ノズル温度270℃で温めてからフィラメントを押し出したところ、フィラメントが問題なく吐出されるようになりました。ノズルからフィラメントは出るようになりましたが、この流れでフィラメント供給口から溶けたフィラメントを引き抜きコールドプル(先述)も行い、ノズル内の汚れを取り除きます。これで今回のメンテナンスは完了です。


詰まりのきっかけになった ABS 樹脂でもプリントに成功。大丈夫そう。


これでダメだった時になにをするか。。。

これでダメなら.... 押し出し機の掃除かな。ペットボトルを溶かして遊んでいたときに、押し出し機とノズルの間にPETカスが残ってしまい、エクストルーダを分解したことはあります。今回はそこまでする必要はありませんでした。


おわりに

0.4mm、 0.2mm のノズルが同じフィラメントにより、この問題で詰まっていました。
プリンタメーカー純正フィラメントをパラメータ設定して造形するのは楽しいのだけど、しかし、同じフィラメントを使ったらまた詰まるんじゃないかと思うと、面倒だなぁという気持ちに……。とはいえ、今回、手許で具体的な対処法を見いだせたので、今後同じことがあってもなんとかなりそうです。


2026年5月19日火曜日

古い Proxmove VE 環境からVMをリカバリする

 古くなったSATA SSDが時々リブートで見えなくなったり、ついには稼働中にI/Oエラーを起こしたりするようになったので交換することにしました。


新しいSSDにProxmox VEをクリーンインストールした後、ダメモトで旧ドライブをUSBマスストレージコントローラ経由で接続したところ、認識成功。見えているうちにデータを復元することにします。

仮想マシンの定義ファイルは /etc/pve/ 以下にあるのだが

Proxmox VE の仮想マシン定義ファイルは /etc/pve/nodes/{hostname}/qemu-server/ 以下にテキストの定義ファイルとして置かれています。これをバックアップするため以下のコマンドを実行しました。

cd /mnt/oldroot
tar cvzf ~/old.etc.pve.tar.gz ./etc/pve
cd ~
tar xvzf old.etc.pve.tar.gz

そうするとあら不思議... 空のディレクトリが。/etc/pve は普通のディレクトリではなく、pmxcfs による分散設定ファイルシステムになっています。実体は /var/lib/pve-cluster/config.db に保存されていました。

ドライブが読めなくなる前にDBファイルを保存します。

cd /mnt/oldroot
tar cvzf ~/old.var.lib.pve-cluster.tar.gz ./var/lib/pve-cluster
cd ~
tar xvzf old.var.lib.pve-cluster.tar.gz

sqlite3で覗いてみます。

% sqlite3 config.db
SQLite version 3.51.0 2025-06-12 13:14:41
Enter ".help" for usage hints.
sqlite> select * from tree;
0|0|46624809|0|1777877202|8|__version__|

6|0|7|0|1682337809|8|datacenter.cfg|keyboard: en-us

8|0|8|0|1682337874|4|virtual-guest|
9|0|9|0|1682337875|4|priv|
11|0|11|0|1682337875|4|nodes|
12|11|12|0|1682337875|4|pve|
13|12|13|0|1682337875|4|lxc|
14|12|14|0|1682337875|4|qemu-server|
15|12|15|0|1682337875|4|openvz|
16|12|16|0|1682337875|4|priv|
17|9|17|0|1682337875|4|lock|
24|0|25|0|1682337875|8|pve-www.key|-----BEGIN RSA PRIVATE KEY-----
...

なるほど、6つ目のフィールドがファイル名で、7つ目のフィールドにファイルコンテンツがあるだけの模様。ただ手作業でファイルをひとつひとつリカバリするのも面倒です。


opencode + Local LLM で DB 構造を解析させリカバリプログラムを書かせる

もう、やることが決まってしまった作業は退屈なだけです。

これぐらいのタスクなら軽量の Local LLM でも十分こなせます。外部のAPIサービスに投げない理由は、DBのなかにシークレットなどの情報が混ざっているかもしれないので、手許で推論します。

Mac に先の sqlite3 データベースをコピー、また適当に python venv を用意して、opencode を起動。プロンプトしました。推論にはローカル LM Studio で動く Qwen 3.6 35B-A3B を使用しました。

you will find config.db file which is in sqlite3 format. inspect its "tree" table and build a python script that recover files in the database. use venv/bin/python


呼吸していたら、動く recover.py が出てきました。(大したものでもないですが gist においておきます

このスクリプトを実行したら確かに DB 内のファイルが recovered/ サブディレクトリに階層構造つきで書き出されました。

% find recovered 
recovered
recovered/mapping
recovered/mapping/directory.cfg
recovered/authkey.pub
recovered/pve-www.key
recovered/sdn
recovered/nodes
recovered/nodes/pve
recovered/nodes/pve/pve-ssl.pem
recovered/nodes/pve/ssh_known_hosts
recovered/nodes/pve/openvz
recovered/nodes/pve/pve-ssl.key
recovered/nodes/pve/lxc
recovered/nodes/pve/qemu-server
recovered/nodes/pve/qemu-server/237.conf
recovered/nodes/pve/qemu-server/104.conf
recovered/nodes/pve/qemu-server/105.conf
recovered/nodes/pve/qemu-server/200.conf
recovered/nodes/pve/qemu-server/102.conf
recovered/nodes/pve/qemu-server/231.conf
recovered/nodes/pve/qemu-server/103.conf
recovered/nodes/pve/qemu-server/100.conf
recovered/nodes/pve/qemu-server/249.conf
recovered/nodes/pve/qemu-server/232.conf
recovered/nodes/pve/qemu-server/245.conf
recovered/nodes/pve/qemu-server/101.conf
recovered/nodes/pve/qemu-server/235.conf
...


VM定義ファイルを新環境に展開

経験上、これで qemu-server/XXX.conf ファイルを書き込んであげればVMが出てくるのを知っています。

% cd recovered/nodes/pve/qemu-server/
% scp * "root@{PVE}:/etc/pve/nodes/pve/qemu-server/"
root@{PVE}'s password: 100.conf 100% 537 113.0KB/s 00:00 101.conf 100% 421 110.6KB/s 00:00 102.conf 100% 575 129.4KB/s 00:00 103.conf 100% 417 84.1KB/s 00:00 104.conf 100% 462 102.1KB/s 00:00 105.conf 100% 462 99.0KB/s 00:00 106.conf 100% 485 103.6KB/s 00:00 200.conf 100% 253 54.6KB/s 00:00 ... 

qemu-server/XXX.conf が復元できれば、Proxmox VE は VM を再認識します。

Proxmox VE のコンソールを確認したところ、仮想マシンがホスト上に表示されるようになりました。


NVMeドライブ上のLVMプールを新環境に追加

仮想マシンのディスク本体は起動ドライブとは別の NVMe ドライブにあるので無事です。ただし、VM定義だけではディスク実体にアクセスできないため、NVMe上のLVM Volume Groupを新しい PVE 環境へ再登録します。

root@pve:~# pvesm add lvm NVMe1_ZP4000GM30023_SERIAL123 --vgname NVMe1_ZP4000GM30023_SERIAL123 \ --content images


ネットワーク設定も単純だったこともあり、過去のドライブ上のISOメディアやUSBデバイスの接続など、イレギュラーな設定が入っているものをのぞけば、これでVMが起動できるところまで復元できました。


古いドライブからVMを救出する場合

古いドライブの LVM に VM がある場合は、VMイメージもリカバリしたくなるかもしれません。Proxmox VE は qm コマンドで VM をオンラインでマイグレーションさせられるので、以下の手順でできそうです。
  • 古いドライブを pvesm add lvm コマンドにて新しい名前で登録
    (デフォルトの LVM 名がコンフリクトする)
  • sed などで VM定義のなかのディスクイメージのプール名を編集
  • qm move_disk で新しいドライブへマイグレーションさせる

今回はこのニーズがないため、この記事では扱いません。


まとめ

Proxmox VE の仮想マシンデータのリカバリを、面倒くさい部分は生成AIで自動化して済ませました。仮想ディスク本体が別ストレージに残っている場合、VM定義ファイルを DB から抜き出してしまえば優勝です。

手間のかかる部分をスクリプト生成・実行で済ませたので何も困ることはありませんでしたが、復元作業よりも、このエントリを書くことのほうに時間がかかりました。

次の投稿ネタまでに、作業記録の記事化をどう自動化するかを考えたほうがいいのかもしれません。

2026年5月1日金曜日

Proxmox VEホストのZFSデータセットにTimeMachineバックアップ

MacBook Proを新しく購入したので、Proxmox VE上のZFSストレージをバックアップ用途として見直し、TimeMachineの保存先として利用することにしました。

■ バックアップの圧縮と暗号化のポリシー: ZFSの機能を利用する

万が一どころか億が一、ハードディスクの持ち去り対策としてデータの暗号化を検討します。まぁ個人の Mac で、プール全体を暗号化していないので片手落ちなのですが...

データの圧縮や暗号化をどのレイヤーで行うか考え、最終的にどちらも ZFS のレイヤで行うことにしました。

結論としては、TimeMachine自体は暗号化することはあっても積極的には圧縮しないようで、ZFSのレイヤで圧縮をかけるとしても、TimeMachineの暗号化を有効にすると、ZFS側での圧縮はほぼ効かなくなります。圧縮したければTimeMachineの暗号化機能は利用しないほうがよい、ということになります。


■ Proxmox VE側の設定

まずは zpool、データセットの準備を行います。

array5 zpool

今回は既存の zpool プールを使用しますので、 zpool の作成方法などについては割愛します。 10TB HDD x5, RAIDZ2 で構成したプールです。

hasegaw@pve:~$ zpool list
NAME     SIZE  ALLOC   FREE  CKPOINT  EXPANDSZ   FRAG    CAP  DEDUP    HEALTH  ALTROOT
array5  45.5T  11.2T  34.3T        -         -     0%    24%  1.00x    ONLINE  -

array5/backup
array5/backup/timemachine

ここにはarray5/backup, array5/backup/timemachine データセットを作成します。まぁ、データセットも作成済みなのですが、

hasegaw@pve:~$ zfs list array5/backup
NAME            USED  AVAIL  REFER  MOUNTPOINT
array5/backup 1.31T 20.2T 211G /export/backup
array5/backup/timemachine 959G 20.2T 185K /export/backup/timemachine

新たに作成するのであれば以下のようなコマンドラインになりますね。

sudo zfs create array5/backup
sudo zfs create -o compression=lz4 array5/backup/timemachine

compression=lz4 を指定していますが、とても積極的な圧縮とまでいかなくても、ゼロが続くような領域についてはランレングス圧縮がかかれば良いな、というぐらいの期待値です。ここで gzip などを指定すれば多少圧縮率もあがるかもしれませんが、CPUサイクルとのバランス感は微妙だと思っています。

また、このホストではデータセットのマウント先を /export/backup にしています。(-o mountpoint=/export/backup)


array5/backup/Arseille

続いて TimeMachine 用の array5/backup/Arseille を作成します。 TimeMachine はマウントされたファイルシステムをまるごとバックアップ先として使用する仕様なので、TimeMachineの単位でSMB共有を作成することになります。

折角なので、ZFSのレイヤでも、ZFSデータセットとしても分けておきます。スナップショット単位の操作(zfs send/recv や destroy)を考えると、分けない理由があまり思いつきません。

  • MacBook Pro の内蔵SSDが 4TB なので、 TimeMachine バックアップと、ストレージが溢れた状態でもある程度の世代が残るように、 5TB でクオータを設定します。
  • 暗号化用の鍵をプロンプトにて指定します。鍵は別途管理します。

root@pve:~# zfs create -o quota=5T -o encryption=aes-256-gcm -o keyformat=passphrase \
-o keylocation=prompt array5/backup/timemachine/Arseille Enter new passphrase: Re-enter new passphrase:

TimeMachineで使用するユーザで、データセットのディレクトリに書き込めるようにしておきます。

# chown hasegaw:hasegaw /export/backup/timemachine/Arseille
hasegaw% touch /export/backup/timemachine/Arseille/hoge
hasegaw% unlink /export/backup/timemachine/Arseille/hoge

Samba のインストール

# apt upgrade
# apt install samba

smbpasswd

まだ Samba 用のパスワードを設定していなければ smbpasswd で設定しておきます。

今回はパスワード登録済みですが、新たに登録する場合は以下のイメージになります。

# smbpasswd -a hasegaw
※ -a は新規ユーザ登録。事前の /etc/passwd にそのユーザを作っておくこと

この SMB サーバに対しては私自身が普段使いのユーザアカウントで SMB マウントするため、今回はメインのユーザアカウントで TimeMachine 接続を想定します。

/etc/samba/smb.conf

もらってきた設定を貼り付けて少し弄っただけですが、以下の要領になります。

  • fruit:time machine=yes
  • fruit:time machine max size = 5000G: 設定は可能なのですが ZFSの quota で最大容量は伝わっているかなと思うので、いったん様子見で外しています。どのように振る舞うのかが判っていませんが、 ZFS 側の制限がハードクオータ、こちらの設定が TimeMachine に対する容量のヒントとして振る舞うように見えるので、 ZFS データセットよりもすこし小さい値に設定してほうがよいかもしれません。
  • ea support = yes となっていますが実際には ZFS レベルで EA を有効化していません。現状、手許では問題なく動いているように見えていますが、将来的に見直すかもしれません。
[timemachine_Arseille]
path = /export/backup/timemachine/Arseille
browseable = yes
read only = no
guest ok = no
writable = yes
valid users = hasegaw
fruit:time machine = yes
; fruit:time machine max size = 5000G
ea support = yes

Samba プロセスを再起動しておきます。

root# systemctl restart smbd


■ Mac 側の設定

MacBook Proからのマウント確認

Finderから Cmd-K 、接続先に smb://hostname_or_ip_address/ を入力し接続します。

ユーザ名、パスワードを聞かれたら PVE ホスト側のユーザ名および先に smbpasswd で指定したパスワードを入力します。

TimeMachine バックアップ先となる timemachine_Arseille 共有が見えたら、それをマウントします。中にフォルダを作成できることを確認し、書き込みが正しくできることを確認できたらテストで作成したフォルダを削除し、共有を改めて空の状態にしておきます。

Finder の左側ペインから、該当する共有のマウントを解除します。

TimeMachine 設定

バックアップ対象の MacBook Pro 側で、以下の要領で TimeMachine 先を設定します。

root# tmutil setdestination smb://user:passwd@hostname/timemachine_Arseille
root# tmutil startbackup

設定で TimeMachine を検索し、バックアップが開始されたことを確認します。


バックアップ終了後に ZFS データセットの割り当て量が増えていることが確認できます。

root@pve:~# zfs list array5/backup/timemachine/Arsielle
NAME                                 USED  AVAIL  REFER  MOUNTPOINT
array5/backup/timemachine/Arsielle  9.17G  4.99T  9.17G  /export/backup/timemachine/Arsielle


■ 再起動後の暗号化解除

Proxmox VEで動作するZFSのプールのうち、該当する timemachine 領域をマウントするには鍵を提供する必要があります。このためホストの再起動後はプールが見えなくなり、バックアップや TimeMachine の内容確認などの操作ができなくなります。

 zfs load-key コマンドにてプロンプトから鍵を入力しアンロックします。

root# zfs load-key array5/backup/timemachine/Arseille
root# systemctl restart smbd

プールが見えない状態では TimeMachine が sparse bundle を見つけられないため、バックアップは(安全に)失敗します。次回以降のバックアップで再マウントいs sparse bundle が見つかれば、バックアップは再開します。


■ ToDo: Mac持ち出し時の他ネットワークでのバックアップ防止

Mac の TimeMachine 機能はスケジュール通りにバックアップを繰り返すため、自宅から Mac を持ち出している間も、 tmutil setdestination で指定した hostname に対して user:passwd でログインしようとする挙動がつづきます。

セキュリティ的には気持ちが悪い挙動なので、ネットワーク条件に応じてTimeMachineを有効/無効に切り替える仕組みを今後検討したいと思います。

クラスCアドレスなので仮にインターネットに繋がっていても経路がなくSMB共有は繋がらないはずですが、接続先のWiFiが(以下自主規制)

かといって、この状況で IPsec などを使うのもどうかと思うし :S 自宅LANに接続していなければ自動バックアップ無効までやりたいと思いますが... これは後日としたいと思います。

2026年4月29日水曜日

Proxmox VEを7.xから9.xへアップデート

 インストール後に割と放置していた Proxmox をアップデートしました。


作業ログをとらずにまとめてやってしまったので具体的なコマンドラインや出力は記載しませんが、おおよその手順としては、下記の手順になります。

  • Proxmove VE 7.x を最新バージョンまでアップデート
    • apt update
    • apt dist-upgrade
  • PVE 7 -> 8 のアップデート検証、アップデート
    • pve7to8 コマンドを実行しアップデート事前検証
      • すでに zfs destroy したプールが見つからない警告が出たので、ここで削除しておく
      • DKMS でインストール済みだった iomemory-vsl について警告が出ていたので、 DKMS を外しておく
      • 推奨に従い VM を停止
    • sed -i 's/bullseye/bookworm/g' /etc/apt/sources.list
    • apt update
    • apt dist-upgrade
    • 新しい kernel もあるため一度再起動、 VMが起動することまで確認しておく
  • PVE 8->9 のアップデート検証
    • pve8to9 コマンドを実行しアップデート事前検証
      • ブートディスク容量不足の警告が出たため ISO イメージを整理
      • 推奨に従い VM を停止
    • sed -i 's/bookworm/trixie/g' /etc/apt/sources.list
    • apt update
    • apt dist-upgrade
    • 再起動、 VMが起動することまで確認

その他考慮したポイントなど
  •  PVE 9.x へのアップデートにあたり多少 grub.cfg が変化しているようで。iommu 関連で GRUB の設定を書き換えていましたが、メンテナ版を受け入れ、個別の修正は改めて適用。
  • smb.conf は現行バージョンを採用。
  • AMD 向けマイクロコードのパッケージなどが表示された案内通りにはインストールできていないが、とりあえずそのままで。
  • GRUB の際インストールを促されたが、案内通りにはうまく進まなかったので、とりあえずそのままで。 boot してるから、まあいいでしょう
  • 当初はクリーンインストールになるのかなと思いながら、手順どおり /etc 以下や /var/lib/ の下などをバックアップしてまわろうと思い作業してましたが、 apt dist-upgrade の手順が出てきた段階で「まあなんとかなるだろう」と思い始めて、そのまま上書きしてしまいました。 Proxmox VE のブートドライブ (SATA 128GB), メインの仮想マシンプール(NVMe 4TB), ストレージアレイ(10TB x5) が別れていたので、失敗してもなんとかなるだろうと思ったのもあります。痛い目に遭いたくなければ、バックアップぐらいは取っておきましょう 

参考にしたURL

  • https://pve.proxmox.com/wiki/Upgrade_from_7_to_8
  • https://pve.proxmox.com/wiki/Upgrade_from_8_to_9


2026年2月14日土曜日

3Dプリンタを併用してSHURE SRH1540用ロングケーブルを製作

SHURE SRH1540

2000年ごろ、大学生のときにATH-A700ヘッドホンを購入してから20年近く使っていたのですが、最終的に樹脂部品が経年劣化で分解してしまい、処分しました。それ以降は解放型の SENHEISER GAME ONE を自宅で使っていたものの、モニタリング用途でどうしても密閉型のヘッドホンが欲しくなり、 SRH1540 を購入。


新品で購入しなくてもよいかなと思い、最終的に3万円台で中古を購入しました。それまでに使っていたヘッドホン類と比べると(新品販売時の価格帯も倍以上と違い)かなり解像度が高く感じ、聞こえ方が別物に感じます。

常用してわかってきた問題点


問題なく聴けているときの利用感は非常に好みです。しかし、常用していると、純正の「左右両だしケーブル」にかなり不便を感じました。

  • ケーブルが 1.5m 程度?で短め
    • 装着状態では身動きをとりづらい
    • ケーブル長から、利用場所の制限を感じる
  • 左右両だし仕様
    • ギターを抱えたり離したりしづらい
    • どちらが右・左か、わからなくなる
  • 3.5ピンコネクタ相性
    • 一般的な3.5ピンコネクタよりも細めなのか、接触不良になりやすい模様。検索すると悩んでいる人がけっこう出てくる

ケーブルの作製を決断、しかしコネクタが手に入らない


先述のトラブル内容でイライラしてしまうので、別のモニタリングヘッドホン購入を検討。しかし定価6万円台のヘッドホンを基準にしてしまうと、次の選択肢もなかなか決まりません。
「最終的に、これ以上ヘッドホン買うよりは SRH1540をなんとか使える状態にしたほうがよいだろう」と思い直し。ケーブルを作製することにしました。

作製にあたり困ったのはコネクタ部分。接点部分は一般的な MMCX ですが、イヤホンのリケーブルなどで使用される MMCX コネクタより細身の独自仕様になっていて、これにあった部品がありません。秋葉原で相談すると「そんなもん売ってねー」と冷たくあしらわれる状況。


既存 MMCX コネクタ + 3Dプリントの自作ハウジング製作にチャレンジ


最終的に NOBUNAGA Labs MMCXプラグ自作キット と、3Dプリントの自作ハウジングで製作にチャレンジすることにしました。


こちらの MMCX コネクタはネジ山が彫ってあるため、ハウジングの内径次第で、よい感じに閉めることができます(オヤイデで取り扱いのあるMMCXコネクタも購入しましたが、こちらにはネジ山がありません)。 Bambu Labs のPLAフィラメントで輪状に出力したハウジングに対して、そのまま締めることができました。

ただ、非常に小さいモノなため、このハウジングは3Dプリントするには 0.4mm ノズルでは難しい印象です。普段はあまり使わない 0.2mm ノズルを利用しました。 0.2mm ノズルで壁ひとつ分の壁厚しかとれないと思います(2壁はチャレンジしていませんが)。変に力をかけると層がはがれて壊れてしまうかもしれませんが。壊れたら、コネクタのはんだ付けからやり直しです(コネクタ部分の再利用はむつかしいと思いますので、修理のタイミングで新しい部品が必要な気がします)。このサイズ感のはんだ付けは得意ではないので、断線・修理が怖いです。

余談ですが、この製作の前に Kaika の P1S 利用可能なノズルを注文していたのですが、他のユーザからのトラブル報告などを経て最終的に入手しませんでした。 0.1mm ノズルが手元にあったら、絶対にプロジェクトでは 使ってみたかったです。

そして、ついに SRH1540 に装着可能な MMCX のハウジングを製作できました。多少不格好ですが、自分で使うには問題ないでしょう。


チャンネルの見分けがつくように片方をマゼンダにしました(CMYKセットとしてもっていたものを利用)


3mの片出しケーブルを作製


SRH1540に対応できるMMCXハウジングを作れてしまえば、もう後は単純なはんだ付け作業です。

今回は 3.5ピン側も NOBUNAGA Labs のものを使いました。正直私には200円未満のプラグとの利用感の違いはわかりませんが……。ピンジャックとSHURE純正プラグの相性問題とも、これでサヨナラです。

ケーブルは、オヤイデの、イヤホン用2芯2ペアのものを使用。作製したのは半年以上前ですが、これがすごく高かった覚えがあります。普通なら3mとかで使うようなものでもない。。。

右チャンネル分は短く、左チャンネル分はヘッドレストを経てコネクタに接続できるように作ったことで、事実上片出し運用ができるようになりました。

作製したケーブルはデスクトップ利用もできますし、ソファでギターを弾いているときにオーディオインターフェイスで音をモニタリングするのにも、不自由なく使えています。


3Dプリンタがあるからこそできた


このケーブルは 2025/7 に作製し、手元の利用ではハウジングが破損することもなく半年以上問題なく利用できています。

この製作のキモは、先述のとおり、特別なMMCXコネクタ用ハウジングの製作でした。もし3Dプリンタが手元になければ、最初から諦めていたと思います。私は手先が器用な方ではないですが、それでも「3Dプリンタで、解決できる課題が広がっている」と感じたプロジェクトでした。

Bambu P1Sアップグレード記録: AMS+Tetras乾燥機, AMSドロア, AMSロングケーブル

 Bambu Labs の P1S を購入してから一年以上がたちました。収益化している人ほどガンガン使ってはいないのですが、けっこう楽しく、便利に利用しています。今回は AMS 関連のアップグレード内容をまとめてみます。


AMS 2段 + EIBOS Series X: Teras 乾燥機

手元ではAMSを2台、P1Sのとなりにおいて運用してきました。合計8スプールを利用可能状態にしておけることで、便利に使っています。

さらに、この半年で、クラウドファンディングで buck していた EIBOS Series X: Tetras が到着。AMSに乾燥機能を追加するシステムです。これを注文したときは AMS2 はまだ出ていませんでしたので、これはAMS無印2台持ちの私にとっては現実的なアップグレードでした。

フィラメントドライヤーとしての Tetras の感想などはあまり書くつもりありませんが、「使用予定をフィラメントをセットして、ボタンを押してドライヤーにかけておくだけ」はとても便利です。PLAは上段メイン、ABSやPETGなどを使うときや、PLAでも乾燥にかけたいときなどは下段のAMS+Tetrasからフィラメント供給しています。

AMSが販売終了になっていることなどを考えると、これから Tetras を入手する人は限られるでしょうし、そもそも入手できる期間も相当限られそうですが、購入してよかったなと思います。


AMSドロア

Tetras 導入前、ダイソーのメタルラック用ポール等で製作したドロアを使用していました。3Dプリンタ購入直後で、モデリングも能力的にもぎりぎり、インサートなどを使うことも考えずに作ったものですが、いくらか問題があったものの便利に運用していました。


第一世代で発生していた問題は以下の部分です。

  • ダイソーのつっぱりミニポール用の棚を棚板として利用していたが、これ自体の強度が足りなかった。
  • 上記にPLAのはりを付けていたが、ありあわせのネジで組み立てた都合で、意図した強度が出ていなかった。
  • P1S - AMS - AMS のケーブルが短かく、ドロアをフル活用できなかった。 -> 後述ケーブルにて解決

この第一世代は、 Tetras 装着後にケーブル長の問題などからメンテ時に負荷がかかり、棚板が崩れてしまったので、第二世代として作り直すことにしました。


第二世代は、 Tetras 装着状態、もしくは未装着状態の AMS を搭載できるように作ってあります。AMSのサイズ感は 256x256 (mm) のベッドでは出力できないため、複数パーツにて構成して、インサートとM3ネジで組み立て、引き出し用のレールに載せています。加重はほとんど左右のレールに固定されたブロックにかかるようになっていて、思ったよりも安定しています。あえて言えば手でひっかける部分を付けておけばよかったか。
本業の始業前などにやっつけでモデリングしたので(言い訳です)あまりかっこよかったりはしませんが、目的達成には十分でした。直したいところがないわけではありませんが、「これでいいや」と使い続けています。
ダイソーポールとアウターレールをとめる部分については過去のプリント品をそのまま再利用しました。


ロングAMSケーブル

これまでの内容のように、AMSを複数台装着していると、AMS本体付属のケーブル(通信&電源)の長さが足りなくなります。ケーブルの長さが足りないことで、以下のような問題が発生します。

  • AMSをプリンタのすぐ隣に配置する必要があり、数センチ離すこともむつかしい。このため P1S 背面へのアクセスがしづらい。
  • 上段AMSと下段AMSのケーブルが短いために、片方のAMSをしっかり前に引き出すことがむつかしい。特に Tetras 装着後は運用上の課題が発生。

このため、付属ケーブルの約2倍の長さで代替のAMS接続ケーブルを作製しました。


AmazonやAliexpressなどで探せば既製品が見つかるかもしれないので、あれば既製品を使ってもいいと思います。私の場合は、このタイプのコネクタの圧着経験などがなかったので、自分で加工してみたかったという理由もあり、自分で製作しました。

ケーブル配線

純正ケーブルは調べたところ以下のシンプルなものでした。この調査結果に基づいてケーブルを製作します。
1-1
2-2
3-3
4-4
5-5
6-6

加工手順

加工は以下の手順で行います。
  • フラットケーブルを必要長さ+αで切断する。
  • 皮むき位置を揃えるため、油性ペンでフラットケーブルで皮むき位置をマークする。
  • 1芯目(赤)~6芯目まで、以下を繰り返す。
    • 皮むき位置で皮をむく。
    • 露出した銅より線が広がってしまう前に、はんだで軽く固めてしまう。
    • MicroFit用ピンソケットに、いちばん奥まで線をつけた状態で被膜もぎりぎり圧着できるところまで導線を切り詰める。
    • ターミナルに線を仮置きした状態で、はんだごての熱で、ケーブル側についたはんだとターミナルを軽くはんだ付け。(はんだを載せすぎると、のちの圧着作業やハウジングへの取り付けができなくなるので、軽めに)
    • 銅線の先側から被膜側まで、圧着工具でかしめていく
    • ケーブル部分からターミナルの先までまっすぐになるようにする。曲がっているとスムーズにターミナルを装着ができない
  • ハウジングを装着
  • テスターにて抵抗値を確認
私はそれ程この手の作業になれておらず、この手順で2本のケーブルを製作するのにおよそ3時間ほどかかりました。
テスターの抵抗値を見る限り問題がなさそうだったので、P1S-AMSの間をこのケーブルで接続してみると、P1S側からAMSのシリアルが正しく取得できていることが確認できました。これを確認の上、2本目に着手、AMS-AMSのデイジーチェーンを自作ケーブルに切り替え。問題なく動作しています。

部材調達メモ

フラットケーブルは、30芯ぐらいのものなら手元にありましたが、ここから6芯で50cm以上もとるには向かなかったので、今回の目的のために購入しました。秋葉原のマルツや千石などに見に行ったところ、思ったものがなく、最終的にオヤイデで5m購入しました。欲しいものが決まっていれば、依頼するだけで店員さんが用意してくれるのはありがたいです(無いものを聞いてしまうとすごい塩対応をくらう印象もありますがww)。
6芯利用なのに8芯を買ってしまったのですが、結果的になんとなく1芯目を赤色にできました。使っていない2芯は、その気になれば裂くだけです。

ケーブルを製作する場合、ターミナルはケーブル1本製作あたり12個、2本では24個必要になります。はんだ付けや圧着の失敗があれば、より多くの部品を消費することになるでしょう。ターミナル購入時は24本+予備を数えて購入は手間です。今回はまとめて100個で買いました。(歳をとって、こういった所をお金で解決できるようになったのは幸せだなあ)

当初は100個単位が店頭になく、通販しようとしたのですが、荷物に不着などの問題がおき、後日に店頭で100個単位で購入しました。

100個パックとはいえ、24個使用すれば 1/4 はすでに使っています。今回は失敗ナシで、無駄が出なかったため、残り76個あるはずですが、3Dプリンタ+電子工作などで何か作るときに利用したいと思っています。

購入から1年以上経過したが、現役スペックで、動かしても拡張しても楽しい P1S

直近では H2C や、 P1S 後継の P2S も販売されており、P1Sは「過去のモデル」となっていますが、自分にとっては P1S はまだまだオモチャ作りで活躍しています。また今回はAMS関連のアップグレードですが、H2Cなどを買ってしまうと、この内容はそのままH2Cに持っていけるでしょう。

購入から一年以上たち販売終了したモデルとはいえ、今回まとめたようなアップグレードに取り組むのも楽しいです。組み立てPCではもはや感じられなくなってしまった楽しさがあるようにーー 8ビット機や16ビット機も楽しく育てていたような人たちはこんな気持ちでパソコンを触っていたのかな、などと思ってみたり。

2025年7月25日金曜日

Taylor 112ce を1年半弾いた

音漏れが怖くて手放したはずのギター。それでも、コードを5つ覚えれば世界が広がるあの感覚を、やっぱりもう一度味わいたくなって、2024年3月に Taylor 112ce-S を購入。

正直「弾いた」というほど弾けないのだが、それは赦してほしい。ギターを探し始めてから約2年の体験をもとに、どうしてこのギターを選んだのか、自分なりにわかってきた向き合い方を振り返ってみる。


2023年の年末、アニメ『ゆびさきと恋々』のOP曲「雪の音」のイントロを聴いた瞬間、10年以上眠っていた“ギターを弾きたい欲”が一気に目を覚ました。

主人公である難聴の女の子の世界で、もし音のない街に雪が降るとしたら──こんなふうに響くのかもしれない。そう思わせてくれる、静かで美しいバッキングだった。


■ 前提条件 — ソロギターへの関心


2007年頃に、いちどギターを入門してみたことがある。

ニコニコ動画の弾いてみた動画で「ああ、楽器ってこんなに自由に弾いていいんだ」と思ってフェルナンデス2万円台のエレキギターを購入。新品で買った国内メーカー品とはいえ、正直、チューニングしてもフレットを押えると音程が合わなくて、頭にハテナを浮かべながらいじっていた(個体のせいかもしれない。ただの思い出の話)。練習したけども、自分が好きなのはアコースティックな音色だと気づいた。

アコースティックギター(厳密にはエレアコ)を譲ってくださるという方がいらっしゃったので、譲っていただいたギターを使って、このアレンジなどを練習していた。


その後の転職で、可処分時間に対する優先度が変わったこと、広さを優先して引っ越した結果音漏れのない新築賃貸から築40年越の団地、またコロナ前に現在の物件に引っ越し。音漏れが怖くて特にアコースティックギターは弾かなくなってしまった。

もう10年まともに弾かなかったギターは弾くことはないだろうと思って、ギターは手放してしまった。しかし何故か突然弾いてみたくなるのがギターという楽器なのかもしれない。コード5つぐらい覚えることができたら、手放さずに手元に置いておいてよい、そんな楽器がギターなのかもしれない。しかし、ギターを一度手放していたからこそ、今回「自分でギターを選ぶ」機会を得たとも言えそうである。

先の経験から、自分が弾きたいのはソロギターに行きつくというのは分かっていた。ぼっち演奏だし、普段ピックでコードをガンガン鳴らしたいというわけでもない。

また、過去に使っていたエレアコは5弦6弦の鳴りが異様に強く感じて、ソロギター的に鳴りすぎて使いづらいという印象があった。いま思えばOMと呼ばれるようなシェイプ相当のもので、主流のドレッドノートシェイプなどと比べれば控えめだったのだろうけど、それでも自分のイメージする音ではなかった。当時のこの感覚は、今回のギター選びで重要なインプットになった。


■ 余談)モデリングギターの可能性の検討


ギターを処分してしまったものの、なぜか処分すると触りたくなるもの。生音に対する恐怖感があったので、アコースティックギターの代わりになるんじゃないかと、知人が持っているLINE6 Variax 300を触らせてもらった(結局、安く譲ってもらった)。


いまでもガジェット的に面白いと思っていて、Variax ラインが終息してなかったら新品で一本買っていたかもしれない。

しかし、このギターをガジェット的に活かすには HELIX というアンプシミュレータも揃えないといけなくて、そちらも結構な金額になる。旧型POD HD500Xという旧型のアンプシミュレータもあって、これもメルカリで購入し試してみたが、実は最新の Windows にドライバが対応していない。

そのほか Gibson がコロナ禍に出したセミアコなども含め調べたのだけど、「やっぱり、アコースティックギターの生音が欲しければ、アコースティックギター弾くしかないんだな」と思った。


■ 「もう手放さない」ギター選び


中途半端な気持ちで手放した経緯があることから、ギターを買うなら次は手放す気持ちにならないギターを手にしたい、という考えがあった。候補を探しているところで Taylor がとても気になり始めた。

  • 工業製品的生産の工夫により、品質が安定していてコストパフォーマンスに優れる
  • 出荷時点にて弾きやすいセットアップ。エレキギターからの持ち替えもしやすいらしい
  • エントリーモデルでも、上位モデルとの遜色のないプレイアビリティ
  • shim (ネックジョイント部に挟み込まれネック角度を変えられる木の板)の交換により、ネック調整ができることは情報として知っていた

また、ギター購入にあたってはGC(Grand Concert)シェイプが最有力候補になった。ドレッドノートのような大型ボディと比べて音量は控えめだが、そのぶん以下のような特徴がある。

  • フィンガーピッキングに適している:軽いタッチでも反応しやすく、ニュアンスが伝わりやすい

  • 中音域が豊かで低音が暴れにくい:ソロギターで和音とメロディを弾き分けやすい

  • 抱えやすく、身体にフィットしやすい:長時間の練習でも疲れにくい

ソロギターをやりたいと思っていた自分にとって、このGCシェイプは理想的だ。

このあたりの情報を知った上で、お茶の水の楽器店で Taylor 112ce のほか YAMAHA LS/LL, そのほか Takamine, Martin, Gibson などを少し触らせてもらいに行った。


触らせてもらった中では 112ce が突出してネックを握りやすく、音も好みだった。この時点で、すでに買うなら 112ce になるのは決まっていたのだと思う。でも最初に触った112ceは、トップの節が個人的には気に入らなかった。店の人は個性でいいじゃないかと言っていたが、後日、別の店にあった 112ce を購入した。

購入した店には 312ce もあったので、そちらも気になった。112ce に対して 312ce は米国内生産、オール単板、インレイがカッコよくなり、ネックやブリッジピンの素材も差別化されている。価格的には大幅に上がるため、その場では興味のないふりをしていたが、いっそのこと 312ce にしておけばよかったかもしれない。

今の自分なら、112ce と並べて弾き比べていただろうし、もし両方を試奏していれば、どちらを選んでも今のようなモヤモヤは残らなかっただろう。

■ ギター入手後の日々


「どんな曲を弾くんですか?」
……ウッ(弾けないッピ)

ギターを購入してエレベータに乗り込む前、店員に聞かれてどう答えようか悩んだ質問。とりあえず、適当に川崎鷹也さんの曲と答えていた。

大して弾けないので参考にしている動画での紹介だけども。。


魔法の絨毯 のコピーTABを練習していたけど、一曲でアルペジオからコード弾き、ブリッジミュートまで入っているので初心者にはスパルタ。1年以上前に譜面を見始めたのに完成してない。

YOASOBIの優しい彗星のソロギターカバーも2024のGW練習していて、GW中の完成を目指したけど、ひどい風邪をひいてその後1~2カ月動けなくなるという状態になり、そのまま未完成。


とはいえ、この1年で「楽器は、ちょっと弾けるだけでも楽しい」と再認識。

出張先などで楽器屋を見つけたら軽く試させてもらったりするようになったけども、慣れだと思うけども、弾き心地なら、自分の 112ce が最高である。


■ ギターのメンテナンスと新曲へのチャレンジ


「弦高3mm以上。店だと商品にならない」

購入から1年経過し、久々に新曲へチャレンジをしたいと思ったが、妙に弦を押えづらくなっている気がするな?と思い、新曲にチャレンジするタイミングで購入店に見てもらうことにした。

結構キツい表現でコンディションについて指摘され、トラスロッドで指板をフラットによせて弦高をいくらか下げてくれたのだが、その店ではたぶん Taylor のメンテナンストレーニングを受けてる人がいないように見えた(実際いないのだろう)。

結局、Taylor ギター専門のリペアマンがいる、東京は初台にあるArtist Loungeに相談して、再度メンテナンスしてもらうことにした。


購入店でのトラスロッド調整は結果的に元に戻されて、shimの入れ替えでコンディションを調整してもらった。工場出荷状態で、ネックコンディションを考慮してか、もともと少し弦高を高めにするセットアップがされて出荷された個体だということが、この時点で分かった。

小指でギュッと抑えていた1弦が指板にはりついてるような感じになり、ずいぶん抑えやすくなり、自分でも違いがわかった。Artist Lounge のクイックリペアサービスで自宅環境に調整された私の 112ce は、メーカー保証期間が10年から12年に延長されたとのこと(なんだって?!)

このArtist Loungeでの調整を経て、Taylorの思想が腑に落ちた。
  • 工場出荷時点ではおそらく比較的無難なセットアップ
  • 購入後にしばらく自宅などにおいて、その環境で慣らす。置き場所によりコンディションは変わる
  • shim の差し替えにより弾きやすい状態にセットアップ(ここでメーカー保証期間が延びるw)
  • それでも四季でどうしてもネックコンディションは変わるが、上下調整すればよい
  • 「弦高調整」を目的としてサドルを削ったりする必要はない

ある程度の湿度管理をしていても、一年を通じて弦高は最大1mmほど上下するものらしい。
購入店ではコンディションについて少々きつい言葉をもらったが、そもそも工場出荷時の状態というのは、ビビりなどを防ぐために弦高がやや高めに設定されているものだ。
そのままの状態で店頭に並び、調整もされずにそのまま受け取ったのであれば、一時的に弦高が3mmを超えていたとしても、何ら不思議ではない。

最近はレギュラーチューニングで弾くことが少なくなっているのも関係しているかもしれないが、クイックリペアから数ヶ月が経過した今の112ceは、セットアップ時と比べて1弦の弦高が約0.2mmほど下ブレしている。
5・6弦が少しビビりやすいのだが、「まあArtist Loungeに持っていけばすぐ解決するし、そのうちまた季節が変わるしな」という圧倒的安心感と余裕になっている。

再セットアップされたギターで練習しているのは TOMOO のコントラストのカバー。

私としては、はじめて非レギュラーチューニングへの挑戦。
ピエゾタイプのチューナーがレギュラーチューニング特化で使いにくかったので、チューナーも買い直す結果に。。。(最初から、ちゃんと音階が表示されるチューナーを買おうってことだな)


■ 湿度管理のプチ見直し


大切にしたいとはいえ、弾いてナンボ、というか弾くために買ったのでしまい込みたいわけでもない。季節によってネックの形状は変わるのは材質的に受け入れること、また、Taylorの場合、それはshimで調整ができるということで、気にしすぎないことにした。

ギターのコンディション維持は「弦を緩めるよりも湿度コントロール」と言われているので、これ以降、夏でも家のエアコン常時稼働で50%~高くなっても60%ぐらいに抑えるようにしている。人のためじゃなくギター(、あとはカメラレンズ)のために24時間エアコンかけてるまである。
本当はもう少し湿度を下げたほうがいいのだろうけど、現実問題として専用の箱を用意するとか色々考えないと難しい。冬に湿度を稼ぐのは、もっと難しそう。


■ Taylor 112ceで気に入っていること、気になっていること


アコースティックギターとの再会、で 112ce には総じて満足している。ここまでの内容と重複、また新規の内容もあるが、いくつか Pros/Cons のポイントを並べてみよう。

〇 抱えやすく、ソロギター向きなバランスのGC シェイプ
Grand Concertシェイプの 112ce はピッキングがヘタクソな自分でもフィンガースタイルでも小柄なボディが反応してくれて、ソロギターとしての十分な低音でてくれる。ピックを使わずに静かに弾きたい自分としては、正しい選択をしたと思っている。

〇 握りやすい、フレット移動しやすいネック
お茶の水で握った 112ce のネックは握った感覚がよかったけど、今でもそう感じる。またネック裏面の塗装的にすべりやすく、力んでもフレット移動しやすい気がする。
また、ネックが細めなのも初心者にも扱いやすいのだと思っている。

〇 クイックリペア余地による絶対的安心感
Taylor のクイックリペアによるネック調整が可能な点は大きなアドバンテージで、安心感につながっている。木工品なのでどうしても季節でコンディションが変わるのを受けいれることになる。他ブランドのアコースティックギターに対する抵抗感にすらなりそう。

☓ バック、サイド板に汗が染みこむ
私は日常的に、速乾系のスポーツウェアを着ている。これの仕組み的に肌の汗を衣類の外側に出すことでドライに保つのだけど、つまり、自分の汗が衣類の表面にいく。これを 112ce のバック材のサペリが吸って、購入当初はサラサラだったバック材がいくらかザラザラになってしまった。
たぶん、自分が汗かき、よく着ている衣類が速乾素材+塗装タイプの組み合わせで起きているのだろと思うけども、長期的なバック材へのダメージが心配。ここだけは「自分にあってないかもなぁ」「ラッカー塗装とかのほうが取り扱いが楽そうだなぁ」と思っている。

☓ Taylor認定リペアマンがいる店で買うべきだった
ここは薄々気づいていたところで詰めが甘かったのだけど、Taylorのリペアトレーニングを受けたリペアマンがいる店で買うべきだった。Taylorのギターをフルスペックで利用するには同社のメンテナンス方式を活用することになる。欲しい個体を売ってみるお店がどこかというのもあるので、考慮する要素の一つに過ぎないが、112ceなら大体の取扱店にある。何にせよ、買ったままにせず、半年ぐらいたったら Taylor クイックリペアは一度お願いするのが良い。
Artist LoungeでTaylor専門のリペアマンに有償メンテナンスしてもらったりすることはできるし、それを第一選択肢にするならそれでよいのだが、ネック取り外しのshim交換まで購入店の無償サービス範疇してもらえるのなら、追加費用なしでの再調整という選択肢は増える。


■ 終わりに


一度熱が冷めても何かの刺激でまた弾いてみたくなる、ギターってそんな楽器だなと。
ソロギターをやってみたいという自分にとって、Taylor 112ceは自分に適した一本を見つけられたと思っている。ボロボロになるまで、大切に家に置いておきたい。

直近では、ブリッジピンをエボニーやTUSQに変えて「味変」してみたりしている。サドルはES2との相性を考えると弄るべきではなさそうという思っているのだが、とはいえ自分は内蔵ピックアップはほとんど使わず、録るときはマイクを立てるようなスタンスなので、自分でサドル削りだすのにもチャレンジしてみたい(どうしても本来の目的よりも下のレイヤにいってしまう...)。

2025年1月26日日曜日

Creality Space Pi フィラメントドライヤー、利用にあたってのベストプラクティス

 3Dプリンター向けのフィラメントを乾燥させるには何等かのフィラメントドライヤーが必要です。私は正直あまり何も考えずに Creality Space Pi フィラメントドライヤーを買いました。Creality Space Pi フィラメントドライヤーを利用するにあたって気づいたことをまとめてみます。


Space Pi フィラメントドライヤー 1ロール


どうしてこのドライヤーを選んだか

買うにあたって「これでいいや」と考えたポイントは以下でした。

  • 置き場所の制約から1スプール用のドライヤー
  • ドライヤーからプリンターにフィラメントを直接フィードできる

他のフィラメントドライヤーと比較したことがないので良し悪しはわからないですが、とりあえず結果的に使えているので大きな問題は感じていません。ただ、この代わりになるものを買い足すのなら、次はコンベクションオーブン等を買ったほうがよいと思っています。


使ってみて気づいたこと

乾燥温度が70度までしか上がりません。 ABS や TPU などのフィラメントでは 80 度前後の乾燥温度が推奨されていることがありますが、このドライヤーではそこまでの温度に上げることはできません。代わりに乾燥時間を長めに設定することで対処します。

フィラメント供給用の穴がありますが、ここからフィラメントと裸で供給するなら問題ないかもしれませんが PTFEチューブで保護した状態で3Dプリンターに送り出したい場合は部品交換したほうがよさそうです。この点については後述します。

スプールがある程度回転するよう、小さなローラーで支えられていますが、ダンボール製スプールなどは安定して供給できないように見えます。複数の理由から、ダンボールスプールに巻かれたフィラメントはプラスチック製のスプールに巻きなおしてから乾燥をはじめるのが正解と思っています。この点についても後述します。

ディスプレイ画面部分が脆いです。タッチパネルとして指で押すだけでも表示が崩れることがありますし、メンテナンスのときにディスプレイ部分を下にして置いたら、壊れたかなと思うぐらいに表示がバグったことがあります(最終的に元に戻りましたが)。温度や時間を操作できなくなると完全なゴミと化します。ここは利用上の注意が必要そうに見えます。ディスプレイ保護フィルムなどを貼っておくのも保険になるかもしれません。


フィラメント供給用穴のアップグレード

ドライヤーの中からフィラメントを供給したい場合のために穴があり、ゴム状のフタがついています。ここからフィラメントを直接供給する場合はよいのですが、せっかく乾燥させたフィラメントを、吸湿を防ぎながら3Dプリンターに送りたければPTFEチューブで接続したくなります。

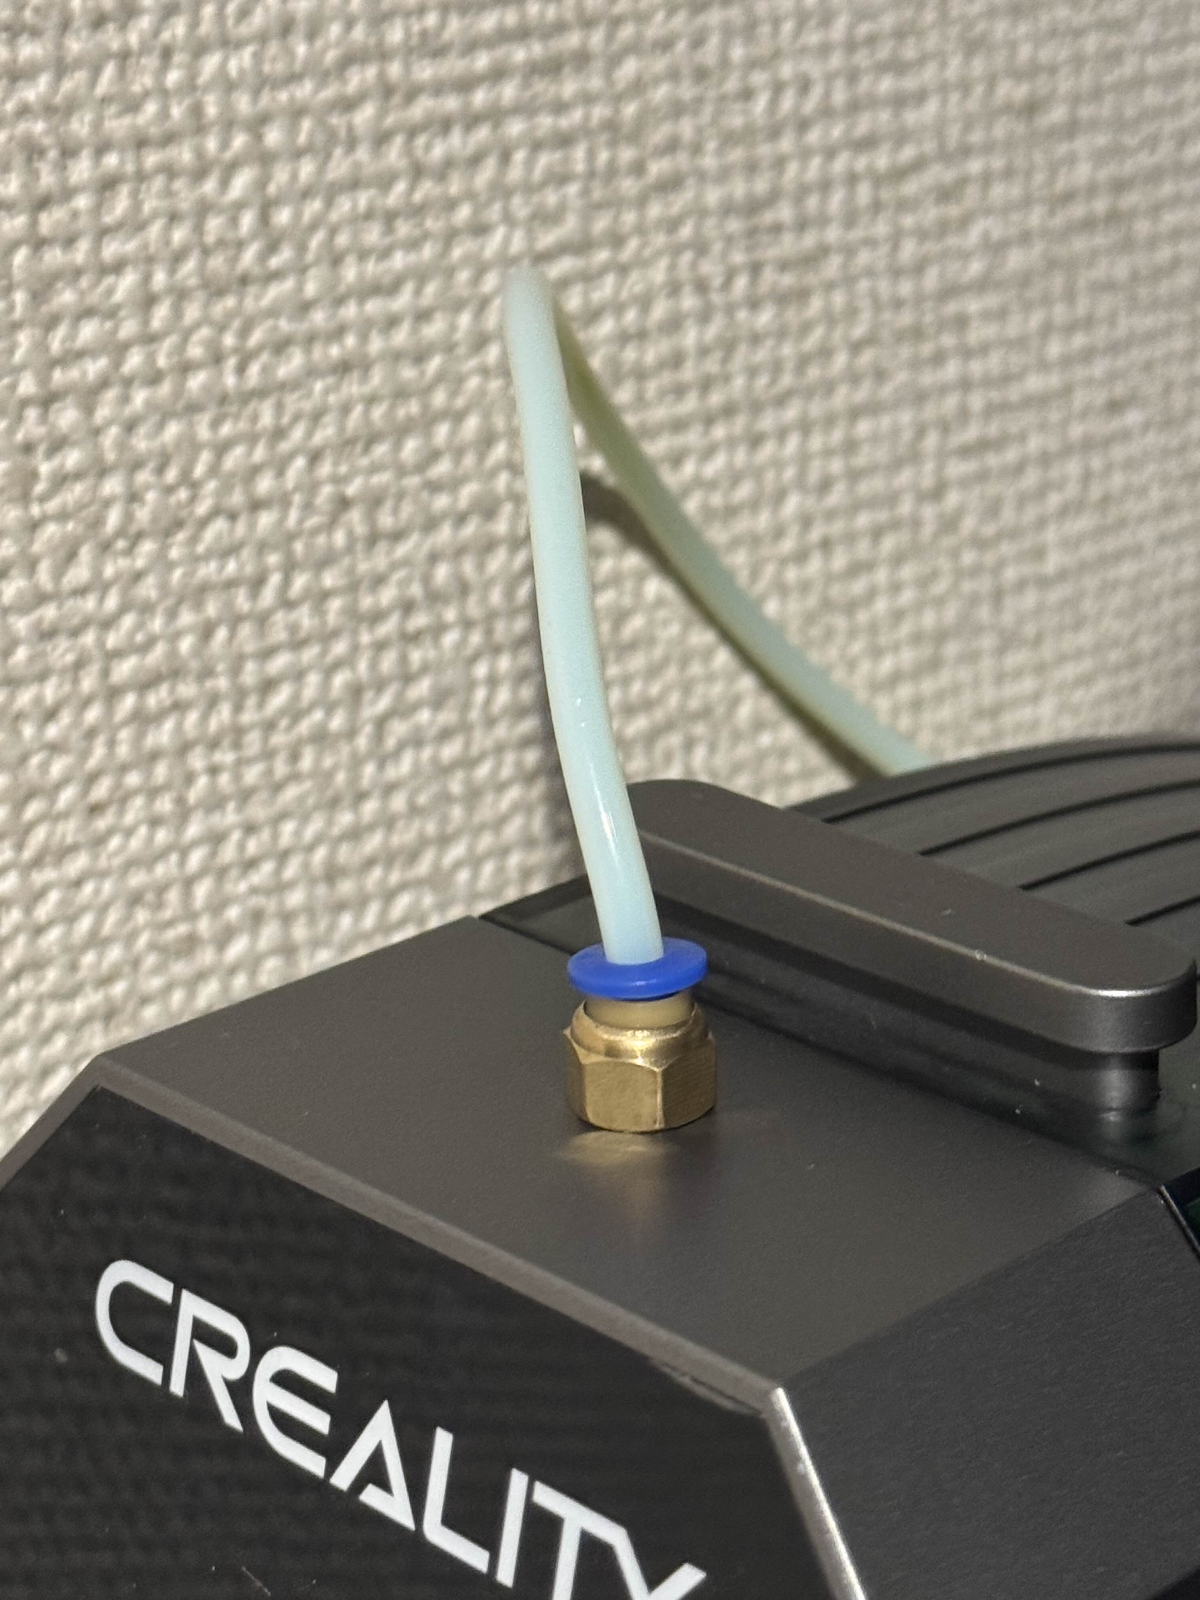
超初心者な私は、ドライヤー本体のゴム状のフタにPTFEチューブを刺してつないだのですが、特に固めのフィラメントだとPTFEチューブが抵抗にまけてフィラメントドライヤー内に引き込まれ、スプールに巻き付くというトラブルになり大変な思いをしました。また、フィラメント押し出し量が不安定になり造形不良につながっているかもしれません。

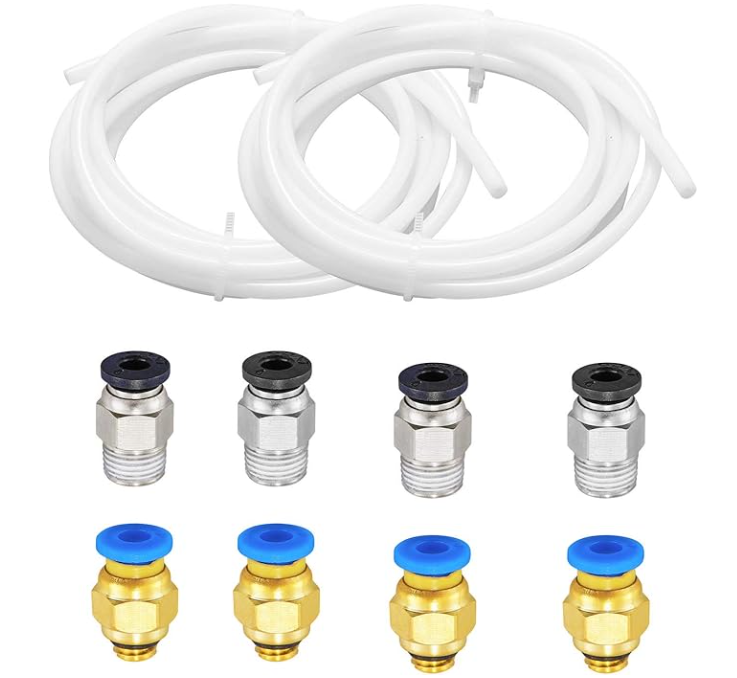
解決先として、フタをこちらに含まれる PC4-M6 の継ぎ手に交換しました。


Litorange PTFEチューブ テフロンチューブ 2mm x 4mm x 2M + PC4-M6 ワンタッチ継手 + PC4-M10 ストレート空気圧継手 1.75mmフィラメント用 3Dプリンターパーツセット (ホワイト)

こちらには長めのPTFEチューブも付いており、フィラメントの供給用にもちょうど良いです。取付には別途M6のナットが必要です。通常のナットだと必要以上の高さがあるので 5mm 程度の M6ナットを3Dプリントしてもよいかもしれませんが(その場合70度の乾燥に耐えるフィラメントを使う必要があります)

Aurooooa 50個入 M6 六角ロックナット ナイロン ロック ナット 高さ6mm 六角幅10mm 304ステンレス鋼 ナイロンインサートセルフロック

このコネクタを取り付けることにより PTFE チューブを本体のフィラメント排出穴に取り付けできるようになり、PTFEチューブで保護した状態で3Dプリンターに送り出せます。


ダンボールスプールからプラスチックスプールに巻き直す

ダンボールスプールに巻かれたフィラメントを乾燥したり造形に使用したりするには以下の問題があると考えてました。

  • ダンボールの吸湿性がそもそも高いので、乾燥させたフィラメントがまたダンボールを通じて吸湿する可能性がある
  • ダンボールスプールのまま Bambu AMS やドライヤーのローラーの上で回すとしても、送り出しに抵抗が発生してうまくいかない
  • ダンボールスプールとローラーが接触する部分を保護するためのリングのモデルが存在するが、PLAなどで造形したこのリングは70度の乾燥に耐えられず歪んでしまう(PAなどで造形すれば使える?)
  • ダンボールが摩耗し紙の粉が発生するとフィラメントに不純物が混じる可能性がある


まあそりゃそうだろという感じではあるが、
70度乾燥に耐えられなかったPLA製ダンボールスプールリング
ローラー跡がついているほか全体的に歪んでいる


こういった理由から、手元では、ダンボールスプールに巻かれたフィラメントはプラチックのスプールに巻き直して使用するほうが遥かに扱いやすく、トラブル切り分けをシンプルにできるため、悩みたくなければ開封してまずはプラスチックスプールに巻き直してしまったほうが良いと考えています。

Bambu の再利用可能スプール。70度の乾燥に耐えられると表記があります
Creality Space Pi ドライヤーの最大温度(70度)で使用して、
いまのところ問題ありません


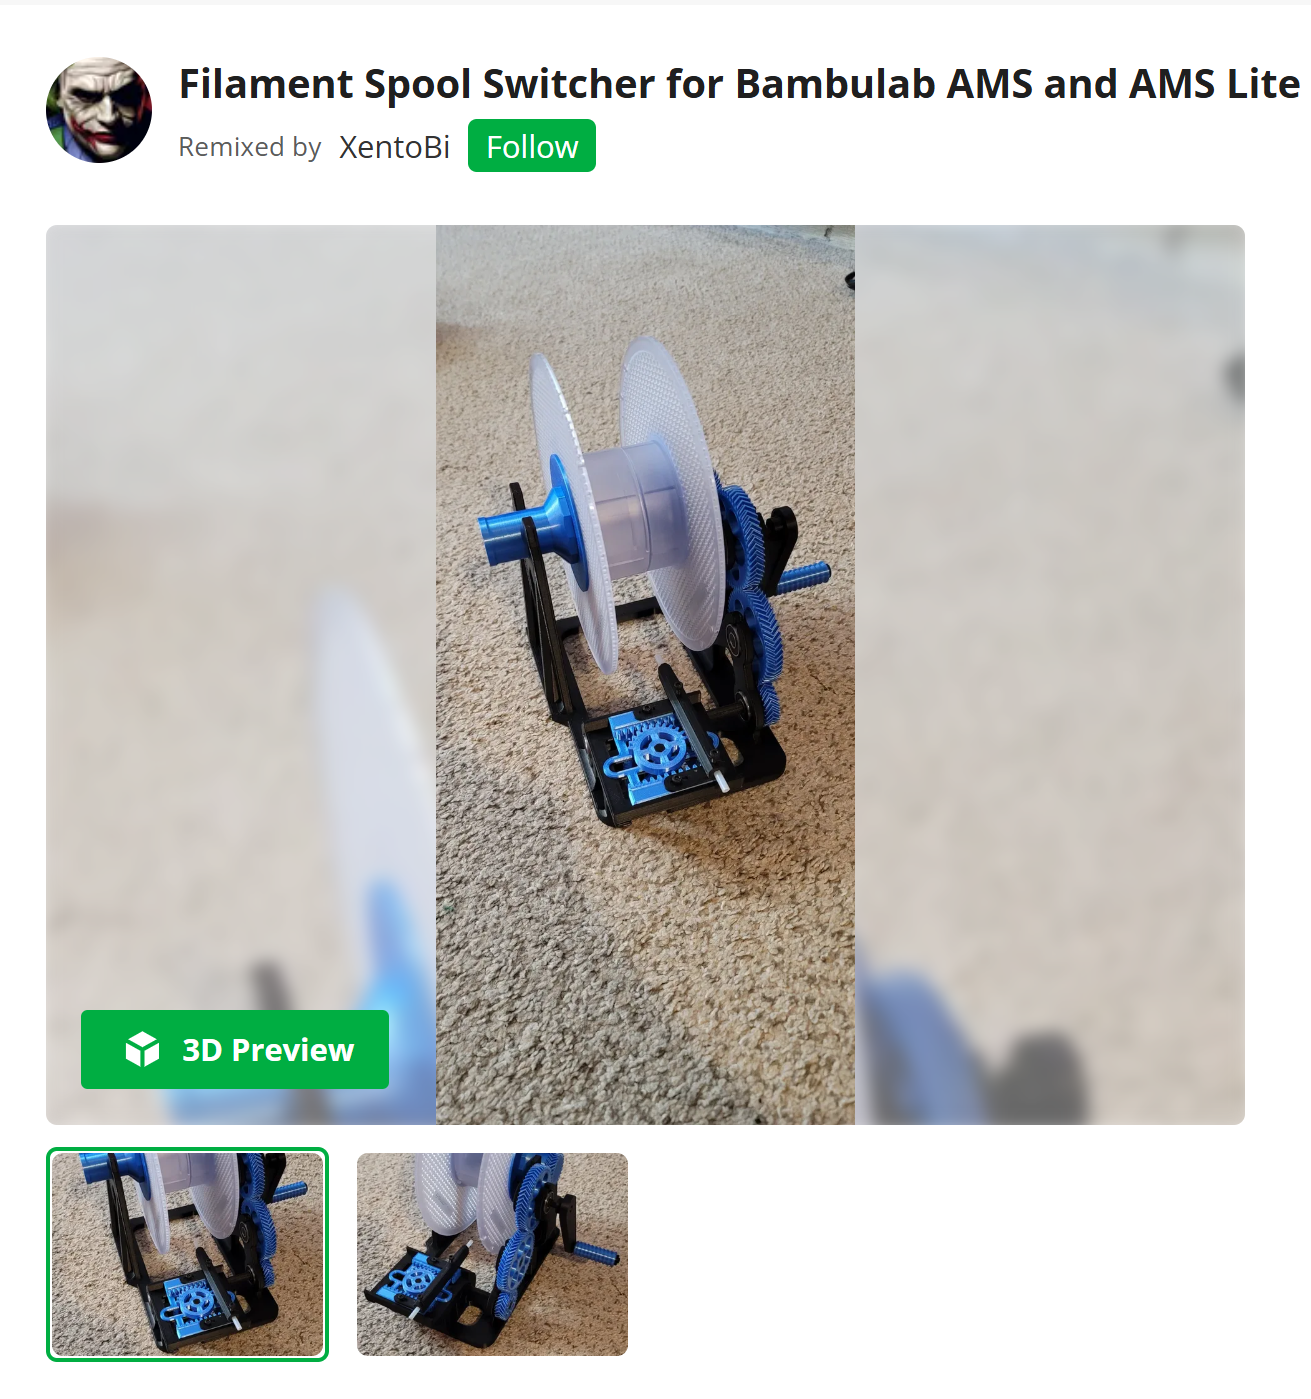
手元では以下のフィラメントリワンダーを造形し、余っている Bambu の再利用可能スプールに巻き直しています。最初は道具なしで巻き直してみたのですが、それではきれいに巻き直すことができませんでした。手作業で苦労して巻き直しているうちにフィラメントに不純物が付着したり、巻きが汚くなったりすることで送り出し~造形時の安定性にリスクを感じました。スプール間の巻き直しに道具は必要です。


Filament Spool Switcher for Bambulab AMS and AMS Lite

このフィラメント巻き器は特に Bambu スプールの径にあわせて作られているので、手元のニーズにあっています。巻取り先スプールが別のものであれば別の巻き器のデザインを見る必要があるのかもしれません。

2025年1月24日金曜日

3Dプリンタを初めて購入した感想など

今更ですが3Dプリンタ Bambu Lab P1S を購入しました。

思ったより楽しくて日々色々出力してみてるのですが、思ったことなどを色々まとめておきたいと思います。

なお3Dプリンタや樹脂を溶かすといった経験についてはここ2カ月弱の経験しかないのでとんちんかんな事を書いているかもしれませんが多めに見て、場合によっては Twitter などでやさしく教えてください。

場所がないので玄関に置いている
背面へのアクセス、上部からのアクセスなどが制限されるので
本当は良い置き場所とはいえない


AMS(フィラメント自動切り替えシステム)は便利

Bambu Lab の現行プリンタは AMS もしくは AMS Lite と呼ばれるフィラント素材を自動的に切り替えてくれるシステムが存在しています。同社のプリンタでは P1S, X1 Carbon では AMS と呼ばれるエンクロージャ式のものが利用できます。AMSには以下のメリットがありました。

  • 多色出力ができる。もちろんフルカラーなどではないですが一部色を変えたい道具類を作りたいときにはとても便利です。
  • サポートのインターフェイスにだけ別素材を使える。後でサポートの取り外しが楽になります。
  • 素材の切り替えが自動。PLA、PETG、ウッドPLAなど複数の素材を自動的に行き来できる。
  • いちおう密閉されておりフィラメントの吸湿をある程度抑えられる。フィラメントを利用可能な状態を保てるため、フィラメント交換や出力を気軽にできます。
X1 Carbon か P1S か

Bambu Lab での個人向け現行最上位機種は X1 Carbon 、それの廉価モデルが P1S になります。はじめての3Dプリンタであったこと、予算的に安いほうがよいと感じたことから P1S 一択で買いましたが、使い始めて知ることで、何が違うのかも色々判ってきました。

X1 Carbon と P1S の差違は基本的に、温度が高い「 PLA や PETG 以外の材質を使いたいかどうか」かなと思いました。

X1 Carbon は高温で出力する素材に対応できる部品が採用されていたり、出力品質安定化のために庫内を暖めたり、高温で臭いやガス、細かな粒子の発生する状況に備えてHEPAフィルタが付いていたりするという点です。総じて PLA や PETG なら P1S で出力すると最初から割り切っていれば P1S で十分ですが、ラボっぽく、いろんな素材を試してみたいと思うのなら X1 Carbon のほうがチャレンジできる幅が広くなります。

一方 P1S でもノズルや押し出しギアなどを X1 Carbon に交換でき、これである程度の素材までは対応できます。とはいえチャンバーの温度コントールなどを後から実装するのは現実的ではないので、 X1 Carbon と互角までは持っていけないですね。

そのほか筐体が金属かプラスチックか、ロッドがカーボンか、ベッドから造形物が外れてしまったら検出できるAIセンサーなどの差がありますが、 P1S でも、とりあえず大抵のことはできるという印象です。 X1 Carbon を買わなかった後悔はせずとも、次の3Dプリンタを選ぶときに自分が選ぶもののスペックが判るようにはなりました。

ノズルの素材と径

私は 0.2mm と 0.6mm の焼き入れスチールを本体とともに購入しましたが、結果的に 0.2mm は使っていません。改めて、焼き入れスチール 0.4mm ノズルを購入して、今はこれが主力になっています。

P1S 向けで提供されるノズルには「ステンレススチール」と「焼き入れスチール」の二種類があります。 P1S では標準で 0.4mm ステンレススチールが装着されていますが、後で交換可能です。

積層型のプリンタでは 0.4mm の径がいまのところ出力品質と速度のバランスが取れており、よく使われる径のようです。スライサー(出力をコントロールするプログラム)の品質向上により 0.6mm でもかなりキレイに出力できるようになってきたようですが、トラブルなくサクサク出力したいなら 0.4mm が安心です。一方、木材を練り込まれたフィラメントなど特殊なものを利用してみたい場合や出力速度を稼ぎたいときには 0.6mm も欲しくなります。

P1Sに標準搭載のステンレススチールのノズルは PLA/PETG を使っているうちは問題ないですが、焼き入れスチールになると摩耗耐性が上がります。より固い材質、カーボンファイバーやガラスファイバーが含まれるフィラメント、ナイロン系フィラメントなどを利用するには焼き入れスチールのノズルが欲しくなります。たとえば歯車などの機械的構造の部品を作りたいとか思ったときに、ここで使える材料に差がでてきます。

 
P1S だと付属はステンレススチールですが、X1 Carbon 同等の焼き入れスチールに交換できるので、必要となったときにさくっと焼き入れスチールに交換してしまうのが良いかと思います。径を変えたいと思わない限りは、もうほとんど交換の手間もありません。

標準の 0.4mm スチールノズルから 0.4mm焼き込みスチールに交換する様子
これでABSやカーボン、ナイロンなども扱えるようになる
焼き込みスチールノズルに交換するなら、
押し出しギアも強化ギア(黒)に変えてしまおう

ツールヘッドから写真の押し出しギアまわりやノズルの部品を取り外して交換作業をしてみると、3Dプリンタのツールヘッドの中身がわかりますし、詰まりの時に何をしたら良いか想像できるようになるので、よい経験になりました。


3Dプリンタで作った3Dプリンタ備品

3Dプリンタを便利に利用するために便利な小物は3Dプリンタで作れます。騒音問題などがなければ、寝るタイミングなどで以下のようなものを仕掛けて作っておくとよいと思います。私は以下のものを作りました。
  • フィラメント交換時に発生するごみフィラメント(poop💩)を受けるくず箱
  • AMSをシリカゲル除湿剤をセットするためのケース
  • X1 / P1 PTFE Tool - P1SとAMSの間などを接続する通信ケーブルやPTFEチューブの付けけ外しに便利

とりあえず シワなしPITのり

PLA/PETGなどだけ扱うのならあまり問題ないでしょうが、取り扱うが難しい素材にチャレンジすると、ベッドにのりをつけて定着改善&PEIプレートを保護したくなります。

まだよく判っていないのですが、 PEI プレートというのは鋼にプラスチックのシールが貼り付けてあるようなものみたいですね。また Bambu 公式サイトを見てもエンジニアリングプレートが出ていないです。結果として本来推奨されない PEI プレート上でエンジニアリングプラスチックを造形しちゃえということになります。

しかし、造形中に外れてしまったり造形物を取り外すときに PEI プレートの表面をもっていかれないように気をつけなければいけません。そのためにはスティックのりをベッドに塗ることになります。

もともと手元にあった大塚商会取り扱いのスティックのり(PVP)を使いましたが、これを塗ると厚みがでてしまい、とても塗りにくいです。シワなしPITはもっと液状っぽくて塗りやすいです。結果としてベッドの段差もできにくいので、とりあえずシワなしPITを買って持っておくのが正解だと思います。

手前にある白のがPVPのスティックのり。
造形中の Benchy の下には実はシワなしPITが塗ってありますが、
薄くぬれているので判らないと思います


フィラメント乾燥機は事実上必要。専用機か食品用のオーブンか

PLAやPETGなどの比較的取り扱いが簡単なフィラメントを気軽に使うためだけでも、フィラメントスプール専用の乾燥機は持っていて損しないと思います。これらの乾燥機からPTFEチューブで直接3Dプリンタに出力できる点は魅力です。

PLA、PETGなら既製の専用フィラメント乾燥機がお手軽だと思っています。ただABSなどのより上位の素材を扱いはじめると、乾燥温度を80度を求められたりすると、このようなフィラメント乾燥機では手に負えなくなってきます。あまり加熱するとプラスチックのスプール自体が溶けてしまうんですね...手元ではABSやナイロンは70度でのんびり乾燥させています。

使い混んでいる方のなかには食品用のコンベクションオーブンを利用している方もいるようで、使いこなせてきたら、そういったものもアリかなと思います。


ノズルの交換がめんどくさい

P1S のノズルの交換はけっこう面倒くさいです。

出力直後だとノズルが熱い可能性があるので火傷の不安があります。私はサーマルカメラを持っているので、視覚的に火傷する温度かどうかは確認できるので何度か確認して、「ああ、この状態でこれぐらい経ったらこれぐらいの温度なんだ」というのを知ってしまいましたが、普通はそんなもの持ってないですよね。

また、Bambu Labの3Dプリンタの場合、ノズル交換にあたって小さなコネクタを3つ付けたり外したりする必要がありますが、私はコレ一発で正しく付けられません。コネクタが小さくて取り付けるのが難しい、壊してしまいそうという不安に加えて、 P1S は構造上プリントヘッドの前側にフレームがくるので視界がとおりにくく、この交換がしづらいです。クリック感がないのでうまく装着できたかわからず、動作させてみたから「ファンの回転数異常です」などのエラーメッセージを受けて問題に気づく、みたいな感じになります。このため必要以上にノズル交換をしたくありません。

コネクタ取り付け失敗対策として、コネクタの高さに対してマーカーでしるしを付けてみました。しるしを付けてからコネクタを弄っていないので、役に立つかどうかはこれからです。

コネクタ縦位置のマーカー

スプールは造形しなくても溜まる

購入した非純正フィラメントや交換用フィラメントだとスプールが無かったり、ダンボール製で印刷に向かなかったりすることがあります。ひとつの解決策はスプールを3Dプリントすることです。

でも、本当に色々なフィラメントで遊び始めると、すぐに再利用可能スプールが溜まりはじめると思います。たとえば Bambu サイトで購入可能なマットPLAのフィラメントは交換用パックとしての販売がないので、これを使おうと思うと必然的に再利用可能なスプールが手元に増えるんです。


PETG(青)でスプールを造形したが結局一度も使わず。
Bambu 純正フィラメントのスプールが何本も余りはじめている

スプールは探すと3Dモデルが出てきて、これを造形すれば造り出すことができます。低コストなフィラメントを探して回る旅をしているのならともかく、 Bambu 純正スプールを何本か試すつもりなら、たぶん必然的に予備スプールが生まれるので、本当に3Dプリントしてまでスプールを増やす必要があるかは疑わしいです。

カーボン強化フィラメント・ガラス強化フィラメントのリスクとナイロン系フィラメントを考える

本体購入と合わせて PLA-CF (カーボンファイバー強化PLA)のフィラメントを購入したり、ABS-GF(ガラスファイバー強化ABS)をフィラメントを購入したりしましたが、ABS-GFは造形しましたがPLA-CFについてはまだ未開封です。特に PLA-CF については、結果的には、意図的に未開封です。

特にカーボン強化フィラメントはフィラメント内にカーボン繊維が練り込まれていて、これは一度体に吸い込むと分解されずに体のどこかに刺さったまま蓄積されてしまう物質ということになると思います。テストプリントでそんなものをボロボロ出してみたり、それをノリで削ったりして吸い込むと本当に体によくないんですね。BambuのCFは日用品の出力例が示されていますが、一般論的に、CFやGFは出力後に塗料で塗装して封印してしまうとか、そういう使い方を前提としてほうがいいのかなと思います。

素材の特性で避けられないということなら仕方ないですが、PLA-CFやABS-GFなどよりも安全そうなものとして、PAや、非純正であればPolymakerのCoPAなどがあります。PAやCoPAは所謂ナイロン系のフィラメントで、こちらは造形時に熱で溶かして一時的に有害なガスが出ることはあっても、カーボンファイバーみたく呼吸器に刺さった状態で蓄積するような恐ろしさは少なそう。


750g 1万円ちょっとと、割と値がはりますが、一週間ほど試行錯誤して、手元のP1Sで割と安定して出力できるようにパラメータを作成することができました。ということで、手元では機械的な部品などを作るときの強化フィラメントとしては、色の選択肢などは少ないですが、まずはCoPAを中心に選ぶことになりそうです。


中国メーカーのサーバーにデータを送るというリスクをどう見るか、直近のネットワーク認証強化についての議論

Bambu Lab 社のプリンタで直近話題になっているネットワーク認証強化の件にもからむところですが、 Bambu Lab のプリンタはアプリケションからプリンタに対して、ジョブをインターネット経由で送信する仕組みになっています。

実は私もこの点は購入前に気になっていて、ある程度割り切って使うことにしました。 Bambu Lab P1S が便利なところは割と設定なしでもモデルを食わせれば勝手に造形物が出てくるところにあり、クラウドへの依存は設定操作をシンプル化するための仕組みです。

自分の造形物データを盗まれるかもしれないとかそういう可能性はゼロではないと思いますが、まぁ自分の造形データを盗むほど価値はないですし、どちらかといえば同社がサービス停止した後にプリンタが文鎮化するのではないかという点を気にしました。本当にクラウドに流したくないデータはSDカード経由でプリンタにデータを入れて造形開始することも可能なので、そういう時はそうするつもりです。

最近ネットワーク認証強化のために、結果的に Orca Slicer などのオープンソースプロジェクトからプリンタへのジョブ直接投入ができなくなるとか、プリンタがセキュリティ対策をせずに丸出しにしていたインターフェイスを使ったサードパーティモジュールが使えなくなるとか、そういった話題で「課金しないとプリンタを使えなくしようとしている」とか大騒ぎしているインフルエンサーがいますが、私にはそこまでには見えません。

3Dプリンタはオープンソース文化との親和性が高く、スライサーソフトなどもユーザや業界の協調で発展してきた経緯から、プロプライエタリなロックが発生するのだと敏感に反応しているように見えます。一方、3Dプリント界隈はコンピュータエンジニア畑ではない人が中心に、「いままでに無かったロックは怖い」というお気持ちを表明しているようにしか、私には見えていません。

恐らく同社が守りたいのは同社が提供するサーバーと、その先に接続されているユーザーのプリンターだと思っています。
Bambu Studio やそれをフォークした Orca Slicer など、そこに含まれたコードが
場合によっては悪意ある攻撃コードの土台にもなりうると思えば、
無償提供・APIが公開されていない自社サービスに対して
サードパーティーが直接接続することを嫌う気持ちはわかる。

ローカルネットワークからプリンタ自体への接続も自社ソフト経由というのは
確かに少しやりすぎにも感じるが、乗っ取られた無線ルータなどから発火させられる
リスク等を回避する方法のひとつ思えばまぁ判る。筋がいいかは微妙だが


最新の家庭用プリンタは 350度ぐらいまでノズル温度を上昇させることができるようになってきて、そこまでの温度で造形するものだとチャンバー温度を高く保てるモデルが増えてくると思います。そういったプリンタをインターネットから操作できるようにして、攻撃者がウチのプリンタを加熱させて意図的に火事を起こすとかそういう行為ができるようなセキュリティホールなら、同社はそれを対処する必要があります。

同社からは、プリンタの認証機能をアップグレードせずに既存のソフトウェアを使い続けたければ現行バージョンを使い続けることで従来のサードパーティーも利用できると案内されていますし、 Developer モードを使えばローカルネットワークでそのセキュリティ機能を回避できる選択肢が用意されることが案内されました。
実際のところiPhone や Android のアプリストアはこの件以上にプラットフォームが強い規制をしていますし、これらのスマホやOculus Questなども同じようにストアを経由しないソフトを動かすためには Developer モードを使用します。コンピュータハードウェアの世界では何年か前にソフトウェアのライセンスを変更して、新ファームウェアにアップロードした後は特定形態での使用を禁止するような製品価値を差損するEULA変更をした企業もありましたが、それと比べたら大した話でもありません。
今回の件が本当に気になるなら、他社の製品を選択したり、純粋にオープンソースのものを選ぶなど、自由に広い選択肢から好きなものを選べばいいと思います。